# C# OCR Image to Text Tutorial: Convert Images to Text Without Tesseract
Szukasz sposobu na konwersję obrazów na tekst w C# bez zawiłości związanych z konfiguracją Tesseract? Ten kompleksowy samouczek IronOCR C# pokazuje, jak wdrożyć zaawansowane rozpoznawanie znaków w aplikacjach .NET za pomocą zaledwie kilku linii kodu.
Quickstart: Wyodrębnij tekst z obrazu w jednej linii
Ten przykład pokazuje, jak łatwo zrozumieć IronOCR - tylko jedna linia C# zamienia twój obraz w tekst. Demonstruje inicjowanie silnika OCR i natychmiastowe odczytywanie oraz pobieranie tekstu bez złożonej konfiguracji.
```cs
:title=Start OCR in Seconds with IronOCR!
string text = new IronTesseract().Read("image.png").Text;
```
<div class="hsg-featured-snippet">
<h3>Minimalny proces (5 kroków)</h3>
<ol>
<li><a class="js-modal-open" data-modal-id="trial-license-after-download" href="https://nuget.org/packages/IronOcr/">Pobierz IronOCR - bibliotekę OCR C# do konwersji obrazu na tekst</a></li>
<li>Użyj klasy <code>IronTesseract</code>, aby natychmiast odczytywać tekst z obrazów</li>
<li>Zastosuj filtry obrazu, aby poprawić dokładność OCR na skanach niskiej jakości</li>
<li>Przetwarzaj wiele języków za pomocą pakietów językowych do pobrania</li>
<li>Eksportuj wyniki jako przeszukiwalne pliki PDF lub wyodrębnij ciągi tekstowe</li>
</ol>
</div>
## Jak odczytać tekst z obrazów w aplikacjach .NET?
Aby osiągnąć funkcjonalność OCR C# konwersji obrazu na tekst w aplikacjach .NET, potrzebujesz niezawodnej biblioteki OCR. IronOCR dostarcza zarządzane rozwiązanie z wykorzystaniem klasy `IronOcr.IronTesseract`, która maksymalizuje zarówno dokładność, jak i szybkość bez potrzeby zewnętrznych zależności.
Najpierw zainstaluj IronOCR do swojego projektu w Visual Studio. Możesz pobrać [bibliotekę DLL IronOCR bezpośrednio](https://www.nuget.org/packages/IronOcr/) lub użyć [NuGet Package Manager](https://www.nuget.org/packages/IronOcr/).
```shell
:ProductInstall
```
## Dlaczego warto wybrać IronOCR do OCR w C# bez Tesseracta?
Kiedy potrzebujesz konwersji obrazów na tekst w C#, IronOCR oferuje znaczące zalety w porównaniu z tradycyjnymi wdrożeniami Tesseract:
- Działa natychmiast w czystych środowiskach .NET
- Nie wymaga instalacji ani konfiguracji Tesseract
- Uruchamia najnowsze silniki: **Tesseract 5** (plus Tesseract 4 i 3)
- Kompatybilny z .NET Framework 4.6.2+, .NET Standard 2+, oraz .NET Core 2, 3, 5, 6, 7, 8, 9 i 10
- Poprawia dokładność i prędkość w porównaniu z czystym Tesseract
- Wspiera wdrożenia Xamarin, Mono, Azure i Docker
- Zarządza złożonymi słownikami Tesseract poprzez pakiety NuGet
- Automatycznie obsługuje pliki PDF, MultiFrame TIFF oraz wszystkie główne formaty obrazów
- Koryguje skany niskiej jakości i przekrzywione dla optymalnych rezultatów
## Jak używać samouczka IronOCR C# do podstawowego OCR?
Ten przykład C# Iron Tesseract pokazuje najprostszy sposób na odczytywanie tekstu z obrazu z użyciem IronOCR. Klasa `IronOcr.IronTesseract` wyodrębnia tekst i zwraca go jako ciąg znaków.
```csharp
using IronOcr;

IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames(@"img\Potter.LowQuality.tiff", pageindices);
input.Deskew(); // removes rotation and perspective
OcrResult result = ocr.Read(input);
Console.WriteLine(result.Text);
```
Ten kod osiąga 100% dokładność na klarownych obrazach, wyodrębniając tekst dokładnie tak, jak się pojawia:
```txt
IronOCR Simple Example
In this simple example we test the accuracy of our C# OCR library to read text from a PNG Image. This is a very basic test, but things will get more complicated as the tutorial continues.
The quick brown fox jumps over the lazy dog
```
Klasa `IronTesseract` obsługuje wewnętrznie skomplikowane operacje OCR. Automatycznie skanuje wyrównanie, optymalizuje rozdzielczość i używa AI do odczytywania tekstu z obrazu za pomocą IronOCR z dokładnością na poziomie ludzkim.
Pomimo skomplikowanego przetwarzania, które odbywa się w tle - w tym analizy obrazu, optymalizacji silnika i inteligentnego rozpoznawania tekstu - proces OCR dopasowuje się do szybkości czytania przez człowieka, utrzymując wyjątkowe poziomy dokładności.
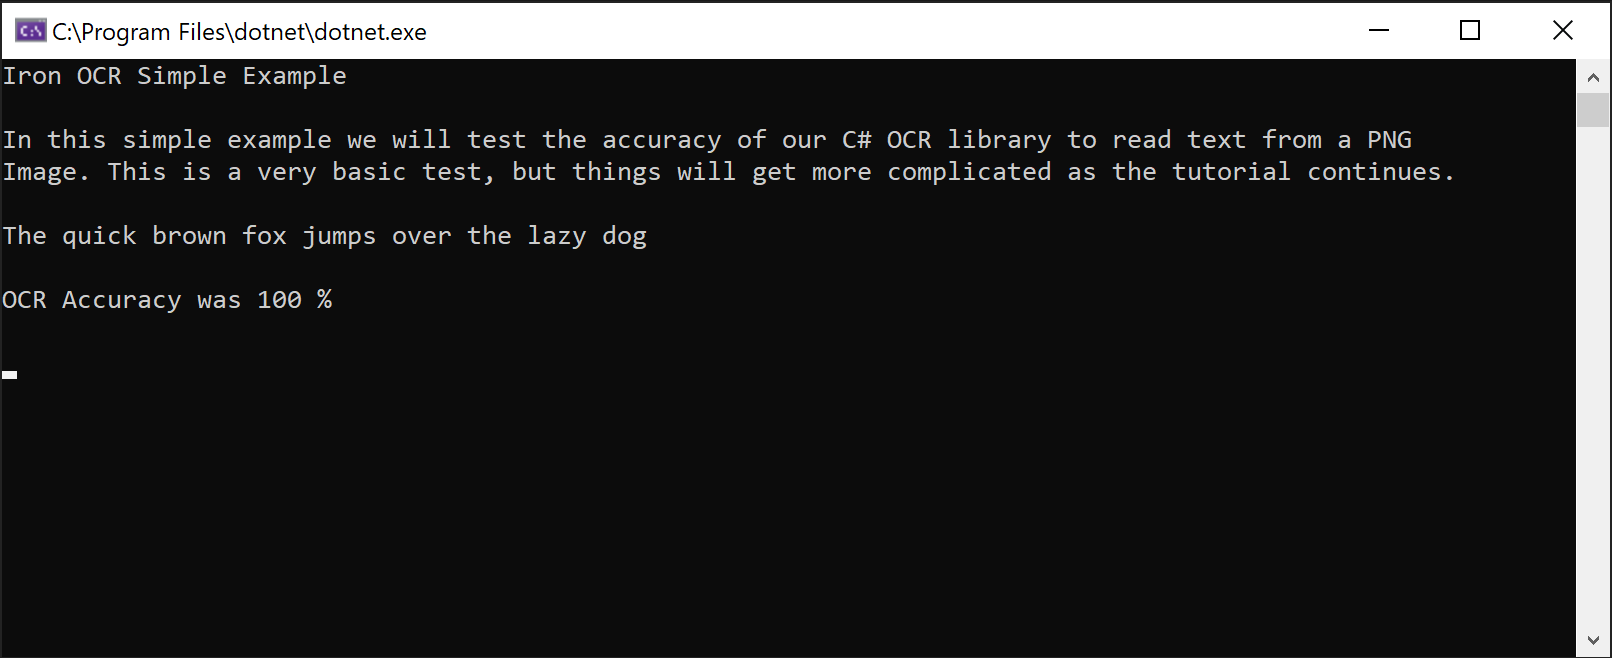
*Zrzut ekranu demonstrujący zdolność IronOCR do wyodrębniania tekstu z obrazu PNG z perfekcyjną dokładnością*
## Jak wdrożyć zaawansowane OCR C# bez konfiguracji Tesseracta?
Dla aplikacji produkcyjnych wymagających optymalnej wydajności przy konwersji obrazów do tekstu w C#, używaj klas `OcrInput` i `IronTesseract` razem. To podejście zapewnia szczegółową kontrolę nad procesem OCR.
### Klasa `OcrInput` Funkcjonalności
- Przetwarza wiele formatów obrazów: JPEG, TIFF, GIF, BMP, PNG
- Importuje kompletne PDF-y lub określone strony
- Poprawia kontrast, rozdzielczość i jakość obrazu automatycznie
- Koryguje obrót, szumy skanowania, przekrzywienie i obrazy negatywowe
### Klasa `IronTesseract` Funkcjonalności
- Dostęp do ponad 127 gotowych pakietów językowych
- Zawiera silniki Tesseract 5, 4 i 3
- Specyfikacja typu dokumentu (zrzut ekranu, fragment lub pełny dokument)
- Zintegrowane funkcje odczytu BarCODE
- Wiele formatów wyjściowych: pliki PDF z możliwością wyszukiwania, HOCR HTML, obiekty DOM i ciągi znaków
### Jak zacząć z `OcrInput` i `IronTesseract`?
Oto zalecana konfiguracja dla tego samouczka IronOCR C#, która działa dobrze z większością typów dokumentów:
```csharp
using IronOcr;
using IronSoftware.Drawing;
IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
// restrict OCR to a content area for faster processing
Rectangle contentArea = new Rectangle(x: 215, y: 1250, height: 280, width: 1335);
input.LoadImage("img/ComSci.png", contentArea);
OcrResult result = ocr.Read(input);
Console.WriteLine(result.Text);
```
Ta konfiguracja konsekwentnie zapewnia niemal idealną dokładność w przypadku skanów o średniej jakości. Metoda `LoadImageFrames` efektywnie obsługuje dokumenty wielostronicowe, co czyni ją idealną dla scenariuszy przetwarzania wsadowego.
<br />
<center>
<a href="/img/tutorials/how-to-read-text-from-an-image-in-csharp-net/Potter.tiff" target="_blank">
<img src="/img/tutorials/how-to-read-text-from-an-image-in-csharp-net/Potter.thumb.png" alt="Wielostronicowy dokument TIFF zawierający tekst o Harrym Potterze, gotowy do przetworzenia przez OCR w języku C#" class="img-responsive add-shadow img-margin" style="max-height:250px; border:1px solid gray" />
</a>
</center>
*Przykładowy dokument TIFF pokazujący możliwości IronOCR w zakresie ekstrakcji tekstu z wielu stron*
Możliwość odczytu tekstu z obrazów i BARCODE-ów w zeskanowanych dokumentach, takich jak pliki TIFF, pokazuje, w jaki sposób IronOCR upraszcza złożone zadania OCR. Biblioteka doskonale radzi sobie z dokumentami z życia codziennego, płynnie obsługując wielostronicowe pliki TIFF i [wyodrębnianie tekstu z plików PDF](/csharp/ocr/how-to/input-pdfs/).
### Jak IronOCR radzi sobie ze skanami niskiej jakości?
<br />
<center>
<a href="/img/tutorials/how-to-read-text-from-an-image-in-csharp-net/Potter.LowQuality.tiff" target="_blank">
<img src="/img/tutorials/how-to-read-text-from-an-image-in-csharp-net/Potter.LowQualitythumb.png" alt="Skan niskiej jakości z cyfrowym szumem, pokazujący możliwości poprawy jakości obrazu IronOCR" class="img-responsive add-shadow img-margin" style="max-height:250px; border:1px solid gray" />
</a>
</center>
*Dokument o niskiej rozdzielczości z zakłóceniami, który IronOCR może dokładnie przetworzyć przy użyciu filtrów obrazu*
W przypadku pracy z niedoskonałymi skanami zawierającymi zniekształcenia i szumy cyfrowe, **biblioteka IronOCR przewyższa inne biblioteki OCR dla języka C#**. Zostało zaprojektowane specjalnie z myślą o rzeczywistych scenariuszach, a nie idealnych obrazach testowych.
```csharp
// PM> Install IronOcr.Languages.Arabic
using IronOcr;
IronTesseract ocr = new IronTesseract();
ocr.Language = OcrLanguage.Arabic;
using OcrInput input = new OcrInput();
input.LoadImageFrame("img/arabic.gif", 1);
// add image filters if needed
// In this case, even thought input is very low quality
// IronTesseract can read what conventional Tesseract cannot.
OcrResult result = ocr.Read(input);
// Console can't print Arabic on Windows easily.
// Let's save to disk instead.
result.SaveAsTextFile("arabic.txt");
```
Użycie `Input.Deskew()` poprawia dokładność do **99,8%** na skanach niskiej jakości, co prawie dorównuje wynikom wysokiej jakości. To pokazuje, dlaczego IronOCR jest preferowanym wyborem dla OCR w C# bez komplikacji związanych z Tesseractem.
Filtry obrazów mogą nieznacznie wydłużyć czas przetwarzania, ale znacznie skrócą całkowity czas trwania OCR. Znalezienie odpowiedniej równowagi zależy od jakości dokumentu.
Dla większości scenariuszy, `Input.Deskew()` i `Input.DeNoise()` zapewniają niezawodne poprawki wydajności OCR. Dowiedz się więcej o [technikach wstępnego przetwarzania obrazów](/csharp/ocr/tutorials/c-sharp-ocr-image-filters/).
## Jak zoptymalizować wydajność i szybkość OCR?
Najważniejszym czynnikiem wpływającym na szybkość OCR podczas konwersji obrazów na tekst w języku C# jest jakość danych wejściowych. Wyższa rozdzielczość (około 200 dpi) przy minimalnym poziomie szumu zapewnia najszybsze i najdokładniejsze wyniki.
Chociaż IronOCR doskonale radzi sobie z poprawianiem dokumentów zawierających błędy, to ulepszenie wymaga dodatkowego czasu przetwarzania.
Wybierz formaty obrazów z minimalnymi artefaktami kompresji. Formaty TIFF i PNG zazwyczaj zapewniają szybsze wyniki niż JPEG ze względu na mniejszy poziom szumu cyfrowego.
### Które filtry obrazu zwiększają szybkość OCR?
Następujące filtry mogą znacznie poprawić wydajność procesu przekształcania obrazów w tekst w języku C# przy użyciu OCR:
- **`OcrInput.Rotate(double degrees)`:** Obraca obrazy zgodnie z ruchem wskazówek zegara (ujemnie dla przeciwnie do ruchu wskazówek)
- **`OcrInput.Binarize()`:** Konwertuje do czarno-białego, poprawiając wydajność przy niskim kontraście
- **`OcrInput.ToGrayScale()`:** Konwertuje do skali szarości dla potencjalnej poprawy szybkości
- **`OcrInput.Contrast()`:** Automatycznie dostosowuje kontrast dla lepszej dokładności
- **`OcrInput.DeNoise()`:** Usuwa cyfrowe artefakty, gdy przewidywany jest szum
- **`OcrInput.Invert()`:** Odwraca kolory dla białego tekstu na czarnym tle
- **`OcrInput.Dilate()`:** Rozszerza granice tekstu
- **`OcrInput.Erode()`:** Zmniejsza granice tekstu
- **`OcrInput.Deskew()`:** Korekta wyrównania - kluczowe dla przekrzywionych dokumentów
- **`OcrInput.DeepCleanBackgroundNoise()`:** Agresywne usuwanie szumów
- **`OcrInput.EnhanceResolution`:** Poprawia jakość obrazów o niskiej rozdzielczości
- **`OcrInput.DetectPageOrientation()`**: Wykrywa i koryguje obrót strony. Przekaż `OrientationDetectionMode`, aby kontrolować kompromis między dokładnością a szybkością: `Fast`, `Balanced`, `Detailed` lub `ExtremeDetailed` (dodano w v2025.8.6)
`Scale()` i `EnhanceResolution()` są niekompatybilne z `SaveAsSearchablePdf()` z powodu znanego problemu w v2025.12.3. Wszystkie inne filtry działają poprawnie przy produkcji przeszukiwalnego PDF.
### Jak skonfigurować IronOCR, aby uzyskać maksymalną prędkość?
Użyj tych ustawień, aby zoptymalizować szybkość przetwarzania skanów o wysokiej jakości:
```csharp
using IronOcr;
IronTesseract ocr = new IronTesseract();
ocr.Language = OcrLanguage.ChineseSimplified;
// We can add any number of languages.
ocr.AddSecondaryLanguage(OcrLanguage.English);
// Optionally add custom tesseract .traineddata files by specifying a file path
using OcrInput input = new OcrInput();
input.LoadImage("img/MultiLanguage.jpeg");
OcrResult result = ocr.Read(input);
result.SaveAsTextFile("MultiLanguage.txt");
```
Ta zoptymalizowana konfiguracja zapewnia **99,8%** dokładności przy jednoczesnym **35-procentowym przyspieszeniu** w porównaniu z ustawieniami domyślnymi.
## Jak czytać określone obszary obrazów, używając OCR w C#?
Poniższy przykład w Iron Tesseract C# pokazuje, jak kierować się do określonych regionów za pomocą `System.Drawing.Rectangle`. Technika ta jest nieoceniona przy przetwarzaniu standardowych formularzy, w których tekst pojawia się w przewidywalnych miejscach.
### Czy IronOCR może przetwarzać przycięte obszary w celu uzyskania szybszych wyników?
Korzystając ze współrzędnych opartych na pikselach, można ograniczyć działanie OCR do określonych obszarów, co znacznie poprawia szybkość i zapobiega niepożądanemu wyodrębnianiu tekstu:
```csharp
using IronOcr;
IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
input.LoadImage("image1.jpeg");
input.LoadImage("image2.png");
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames("image3.gif", pageindices);
OcrResult result = ocr.Read(input);
Console.WriteLine($"{result.Pages.Length} Pages"); // 3 Pages
```
To ukierunkowane podejście zapewnia **41% wzrost szybkości** przy wyodrębnianiu wyłącznie istotnego tekstu. Idealnie nadaje się do dokumentów o ustalonej strukturze, takich jak [faktury](/csharp/ocr/blog/using-ironocr/invoice-ocr-csharp-tutorial/), czeki i formularze. Ta sama technika przycinania działa płynnie w [operacjach OCR plików PDF](/csharp/ocr/how-to/input-pdfs/).
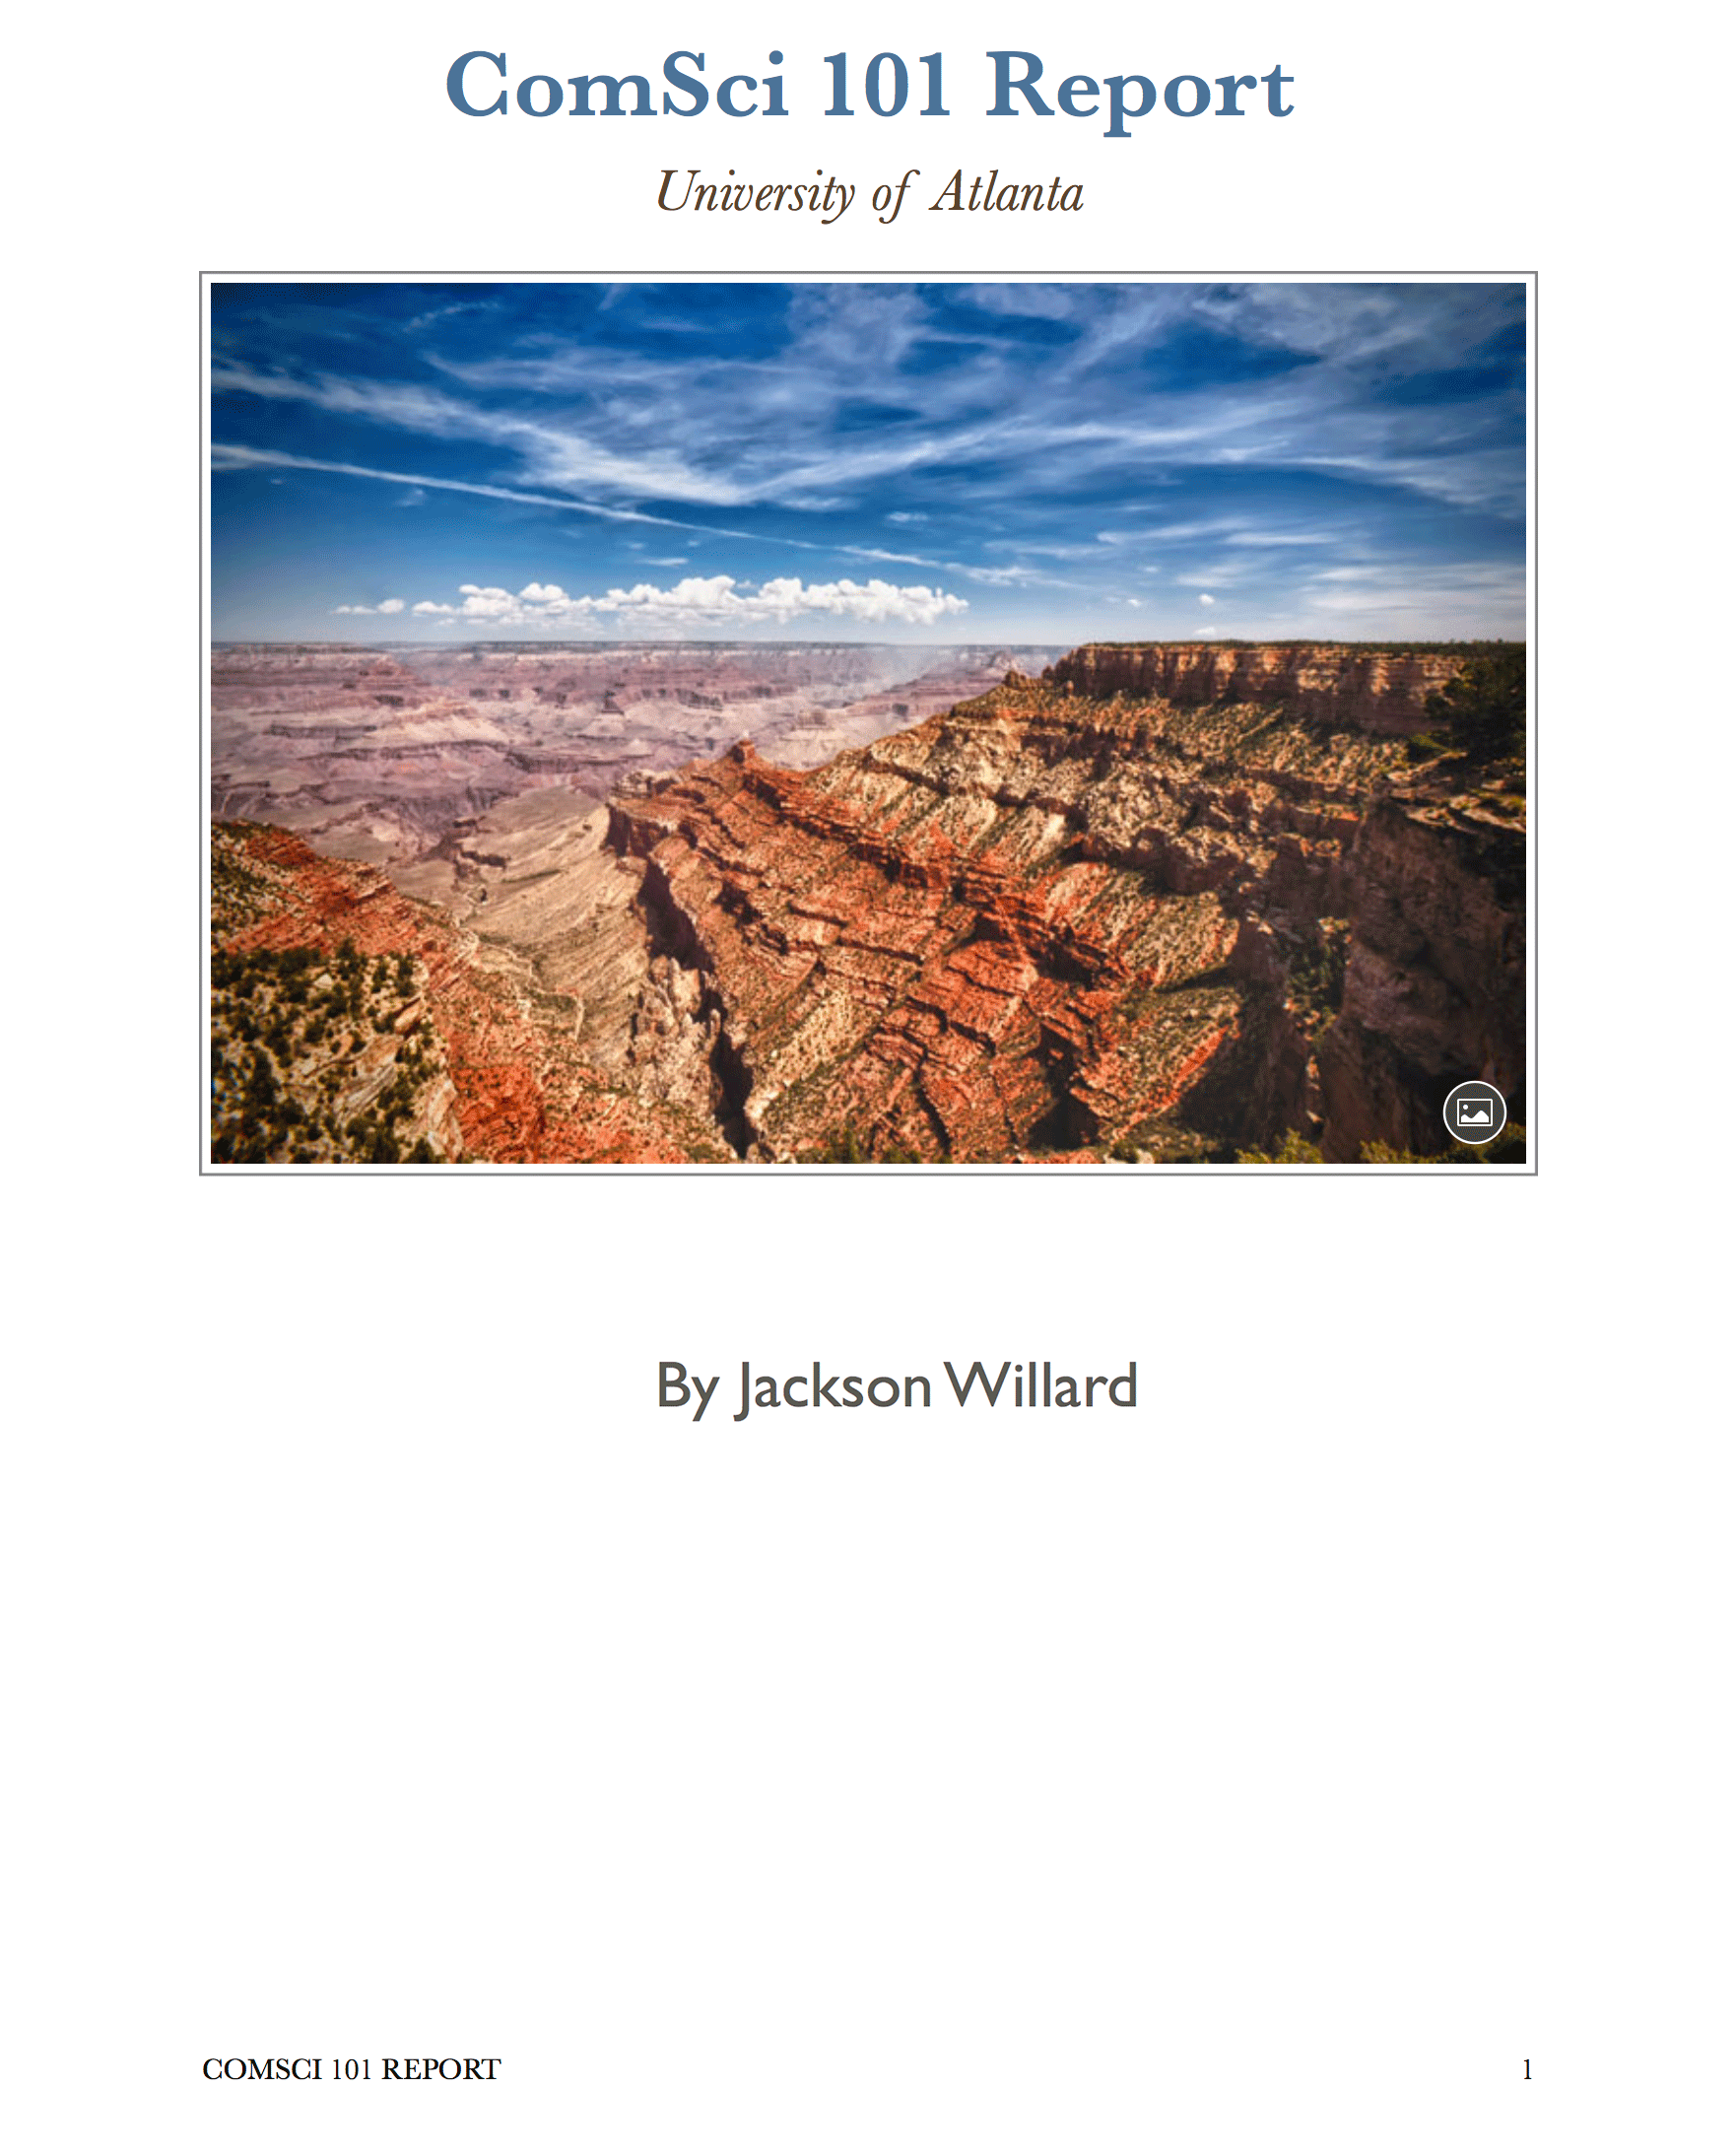
*Dokument pokazujący precyzyjne wyodrębnianie tekstu na podstawie regionu przy użyciu zaznaczenia prostokątnego w IronOCR*
## Ile języków obsługuje IronOCR?
IronOCR oferuje **127 języków międzynarodowych** w postaci wygodnych pakietów językowych. Pobierz je jako pliki DLL z naszej strony internetowej lub za pośrednictwem [menedżera pakietów NuGet](https://www.nuget.org/packages?q=IronOcr.Languages).
Zainstaluj pakiety językowe za pośrednictwem interfejsu NuGet ([wyszukaj "IronOcr.Languages"](https://www.nuget.org/packages?q=IronOcr.Languages)) lub odwiedź [pełną listę pakietów językowych](/csharp/ocr/languages/).
Obsługiwane języki to arabski, chiński (uproszczony/tradycyjny), japoński, koreański, hindi, rosyjski, niemiecki, francuski, hiszpański oraz ponad 115 innych, z których każdy jest zoptymalizowany pod kątem dokładnego rozpoznawania tekstu.
### Jak wdrożyć OCR w wielu językach?
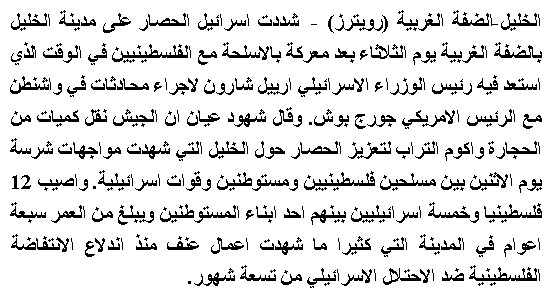
Ten przykładowy samouczek IronOCR w języku C# pokazuje rozpoznawanie tekstu arabskiego:
```shell
:InstallCmd Install-Package IronOcr.Languages.Arabic
```
<center>
<img src="/img/tutorials/how-to-read-text-from-an-image-in-csharp-net/arabic.gif" alt="Tekst arabski przetwarzany przez IronOCR, demonstrujący obsługę wielojęzycznego OCR" class="img-responsive add-shadow img-margin" style="max-height:250px; border:1px solid gray;" />
</center>
*IronOCR dokładnie wyodrębnia tekst arabski z obrazu GIF*
```csharp
using IronOcr;
IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
input.LoadPdf("example.pdf", Password: "password");
// We can also select specific PDF page numbers to OCR
OcrResult result = ocr.Read(input);
Console.WriteLine(result.Text);
Console.WriteLine($"{result.Pages.Length} Pages");
// 1 page for every page of the PDF
```
### Czy IronOCR obsługuje dokumenty w wielu językach?
Jeśli dokumenty zawierają różne języki, skonfiguruj IronOCR do obsługi wielu języków:
```shell
:InstallCmd Install-Package IronOcr.Languages.ChineseSimplified
```
```csharp
using IronOcr;
IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
input.Title = "Pdf Metadata Name";
input.LoadPdf("example.pdf", Password: "password");
OcrResult result = ocr.Read(input);
result.SaveAsSearchablePdf("searchable.pdf");
```
## Jak przetwarzać dokumenty wielostronicowe za pomocą OCR w C#?
IronOCR płynnie łączy wiele stron lub obrazów w pojedynczy `OcrResult`. Ta funkcja zapewnia zaawansowane możliwości, takie jak [tworzenie plików PDF z funkcją wyszukiwania](/csharp/ocr/how-to/searchable-pdf/) oraz wyodrębnianie tekstu z całych zestawów dokumentów.
Łącz i dopasowuj różne źródła - obrazy, ramki TIFF i strony PDF - w ramach jednej operacji OCR:
```csharp
using IronOcr;
IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
input.Title = "Pdf Title";
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames("example.tiff", pageindices);
OcrResult result = ocr.Read(input);
result.SaveAsSearchablePdf("searchable.pdf");
```
Wydajne przetwarzanie wszystkich stron pliku TIFF:
```csharp
using IronOcr;
IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
input.Title = "Html Title";
// Add more content as required...
input.LoadImage("image2.jpeg");
input.LoadPdf("example.pdf",Password: "password");
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames("example.tiff", pageindices);
OcrResult result = ocr.Read(input);
result.SaveAsHocrFile("hocr.html");
```
Konwertuj pliki TIFF lub PDF do formatów umożliwiających wyszukiwanie:
```csharp
using IronOcr;
IronTesseract ocr = new IronTesseract();
ocr.Configuration.ReadBarCodes = true;
using OcrInput input = new OcrInput();
input.LoadImage("img/Barcode.png");
OcrResult result = ocr.Read(input);
foreach (var barcode in result.Barcodes)
{
Console.WriteLine(barcode.Value);
// type and location properties also exposed
}
```
Konwersja istniejących plików PDF do wersji z możliwością wyszukiwania:
```csharp
using IronOcr;
using IronSoftware.Drawing;
// We can delve deep into OCR results as an object model of Pages, Barcodes, Paragraphs, Lines, Words and Characters
// This allows us to explore, export and draw OCR content using other APIs
IronTesseract ocr = new IronTesseract();
ocr.Configuration.ReadBarCodes = true;
using OcrInput input = new OcrInput();
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames(@"img\Potter.tiff", pageindices);
OcrResult result = ocr.Read(input);
foreach (var page in result.Pages)
{
// Page object
int pageNumber = page.PageNumber;
string pageText = page.Text;
int pageWordCount = page.WordCount;
// null if we don't set Ocr.Configuration.ReadBarCodes = true;
OcrResult.Barcode[] barcodes = page.Barcodes;
AnyBitmap pageImage = page.ToBitmap(input);
System.Drawing.Bitmap pageImageLegacy = page.ToBitmap(input);
double pageWidth = page.Width;
double pageHeight = page.Height;
foreach (var paragraph in page.Paragraphs)
{
// Pages -> Paragraphs
int paragraphNumber = paragraph.ParagraphNumber;
String paragraphText = paragraph.Text;
System.Drawing.Bitmap paragraphImage = paragraph.ToBitmap(input);
int paragraphXLocation = paragraph.X;
int paragraphYLocation = paragraph.Y;
int paragraphWidth = paragraph.Width;
int paragraphHeight = paragraph.Height;
double paragraphOcrAccuracy = paragraph.Confidence;
var paragraphTextDirection = paragraph.TextDirection;
foreach (var line in paragraph.Lines)
{
// Pages -> Paragraphs -> Lines
int lineNumber = line.LineNumber;
String lineText = line.Text;
AnyBitmap lineImage = line.ToBitmap(input);
System.Drawing.Bitmap lineImageLegacy = line.ToBitmap(input);
int lineXLocation = line.X;
int lineYLocation = line.Y;
int lineWidth = line.Width;
int lineHeight = line.Height;
double lineOcrAccuracy = line.Confidence;
double lineSkew = line.BaselineAngle;
double lineOffset = line.BaselineOffset;
foreach (var word in line.Words)
{
// Pages -> Paragraphs -> Lines -> Words
int wordNumber = word.WordNumber;
String wordText = word.Text;
AnyBitmap wordImage = word.ToBitmap(input);
System.Drawing.Image wordImageLegacy = word.ToBitmap(input);
int wordXLocation = word.X;
int wordYLocation = word.Y;
int wordWidth = word.Width;
int wordHeight = word.Height;
double wordOcrAccuracy = word.Confidence;
if (word.Font != null)
{
// Word.Font is only set when using Tesseract Engine Modes rather than LTSM
String fontName = word.Font.FontName;
double fontSize = word.Font.FontSize;
bool isBold = word.Font.IsBold;
bool isFixedWidth = word.Font.IsFixedWidth;
bool isItalic = word.Font.IsItalic;
bool isSerif = word.Font.IsSerif;
bool isUnderlined = word.Font.IsUnderlined;
bool fontIsCaligraphic = word.Font.IsCaligraphic;
}
foreach (var character in word.Characters)
{
// Pages -> Paragraphs -> Lines -> Words -> Characters
int characterNumber = character.CharacterNumber;
String characterText = character.Text;
AnyBitmap characterImage = character.ToBitmap(input);
System.Drawing.Bitmap characterImageLegacy = character.ToBitmap(input);
int characterXLocation = character.X;
int characterYLocation = character.Y;
int characterWidth = character.Width;
int characterHeight = character.Height;
double characterOcrAccuracy = character.Confidence;
// Output alternative symbols choices and their probability.
// Very useful for spell checking
OcrResult.Choice[] characterChoices = character.Choices;
}
}
}
}
}
```
Zastosuj tę samą technikę do konwersji plików TIFF:
```csharp
using IronOcr;
var ocr = new IronTesseract();
using (var input = new OcrInput())
{
// Configure document properties
input.Title = "Scanned Archive Document";
// Select pages to process
var pageIndices = new int[] { 1, 2 };
input.LoadImageFrames("example.tiff", pageIndices);
// Create searchable PDF from TIFF
OcrResult result = ocr.Read(input);
result.SaveAsSearchablePdf("searchable.pdf");
}
```
## Jak wyeksportować wyniki OCR jako HOCR HTML?
IronOCR obsługuje eksport HOCR HTML, umożliwiając konwersję **plików PDF** o strukturze **do formatu HTML** oraz **plików TIFF do formatu HTML** przy zachowaniu informacji o układzie:
```csharp
using IronOcr;
var ocr = new IronTesseract();
using (var input = new OcrInput())
{
// Set HTML title
input.Title = "Document Archive";
// Process multiple document types
input.LoadImage("image2.jpeg");
input.LoadPdf("example.pdf", "password");
// Add TIFF pages
var pageIndices = new int[] { 1, 2 };
input.LoadImageFrames("example.tiff", pageIndices);
// Export as HOCR with position data
OcrResult result = ocr.Read(input);
result.SaveAsHocrFile("hocr.html");
}
```
## Czy IronOCR może odczytywać BarCodes wraz z tekstem?
IronOCR w unikalny sposób łączy rozpoznawanie tekstu z [możliwością odczytu kodów kreskowych](/csharp/ocr/how-to/barcodes/), eliminując potrzebę stosowania oddzielnych bibliotek:
```csharp
// Enable combined text and barcode recognition
using IronOcr;
var ocr = new IronTesseract();
// Enable barcode detection
ocr.Configuration.ReadBarCodes = true;
using (var input = new OcrInput())
{
// Load image containing both text and barcodes
input.LoadImage("img/Barcode.png");
// Process both text and barcodes
var result = ocr.Read(input);
// Extract barcode data
foreach (var barcode in result.Barcodes)
{
Console.WriteLine($"Barcode Value: {barcode.Value}");
Console.WriteLine($"Format: {barcode.Format}");
}
}
```
## Jak uzyskać dostęp do szczegółowych wyników OCR i metadanych?
Obiekt wyników IronOCR dostarcza kompleksowych danych, które zaawansowani programiści mogą wykorzystać w zaawansowanych aplikacjach.
Każdy `OcrResult` zawiera hierarchiczne kolekcje: strony, akapity, linie, słowa i znaki. Wszystkie elementy zawierają szczegółowe metadane, takie jak lokalizacja, informacje o czcionkach i wskaźniki pewności.
Poszczególne elementy (akapity, słowa, BarCodes) można eksportować jako obrazy lub mapy bitowe w celu dalszego przetwarzania:
```csharp
using System;
using IronOcr;
using IronSoftware.Drawing;
// Configure with barcode support
IronTesseract ocr = new IronTesseract
{
Configuration = { ReadBarCodes = true }
};
using OcrInput input = new OcrInput();
// Process multi-page document
int[] pageIndices = { 1, 2 };
input.LoadImageFrames(@"img\Potter.tiff", pageIndices);
OcrResult result = ocr.Read(input);
// Navigate the complete results hierarchy
foreach (var page in result.Pages)
{
// Page-level data
int pageNumber = page.PageNumber;
string pageText = page.Text;
int pageWordCount = page.WordCount;
// Extract page elements
OcrResult.Barcode[] barcodes = page.Barcodes;
AnyBitmap pageImage = page.ToBitmap();
double pageWidth = page.Width;
double pageHeight = page.Height;
foreach (var paragraph in page.Paragraphs)
{
// Paragraph properties
int paragraphNumber = paragraph.ParagraphNumber;
string paragraphText = paragraph.Text;
double paragraphConfidence = paragraph.Confidence;
var textDirection = paragraph.TextDirection;
foreach (var line in paragraph.Lines)
{
// Line details including baseline information
string lineText = line.Text;
double lineConfidence = line.Confidence;
double baselineAngle = line.BaselineAngle;
double baselineOffset = line.BaselineOffset;
foreach (var word in line.Words)
{
// Word-level data
string wordText = word.Text;
double wordConfidence = word.Confidence;
// Font information (when available)
if (word.Font != null)
{
string fontName = word.Font.FontName;
double fontSize = word.Font.FontSize;
bool isBold = word.Font.IsBold;
bool isItalic = word.Font.IsItalic;
}
foreach (var character in word.Characters)
{
// Character-level analysis
string charText = character.Text;
double charConfidence = character.Confidence;
// Alternative character choices for spell-checking
OcrResult.Choice[] alternatives = character.Choices;
}
}
}
}
}
```
## Podsumowanie
IronOCR zapewnia programistom C# najbardziej zaawansowaną [implementację API Tesseract](/csharp/ocr/), działającą płynnie na platformach Windows, Linux i Mac. Możliwość dokładnego odczytu tekstu z obrazu za pomocą IronOCR - nawet z dokumentów o niskiej jakości - wyróżnia to rozwiązanie spośród podstawowych rozwiązań OCR.
Unikalne funkcje biblioteki obejmują zintegrowane odczytywanie kodów BarCode oraz możliwość eksportowania wyników jako pliki PDF z funkcją wyszukiwania lub HOCR HTML, co nie jest dostępne w standardowych implementacjach Tesseract.
### Kolejne kroki
Aby kontynuować naukę obsługi IronOCR:
- Zapoznaj się z naszym [obszernym przewodnikiem dla początkujących](/csharp/ocr/docs/)
- Przeglądaj [praktyczne przykłady kodu w języku C#](/csharp/ocr/examples/simple-csharp-ocr-tesseract/)
- Zapoznaj się ze [szczegółową dokumentacją API](/csharp/ocr/object-reference/)
### Pobierz kod źródłowy
- [Repozytorium GitHub](https://github.com/iron-software/IronOcr.Examples/tree/main/src/IronSoftware.IronOcr.Examples/IronSoftware.IronOcr.Examples)
- [Pobierz pełny tekst źródłowy](/downloads/assets/tutorials/how-to-read-text-from-an-image-in-csharp-net/CSharp-Image-to-Text.zip)
Gotowy do wdrożenia konwersji obrazu OCR C# na tekst w swoich aplikacjach? [Pobierz IronOCR](download-modal) i rozpocznij swoją [bezpłatną wersję próbną](trial-license) już dzisiaj.
Szukasz sposobu na konwersję obrazów na tekst w C# bez zawiłości związanych z konfiguracją Tesseract? Ten kompleksowy samouczek IronOCR C# pokazuje, jak wdrożyć zaawansowane rozpoznawanie znaków w aplikacjach .NET za pomocą zaledwie kilku linii kodu.
Quickstart: Wyodrębnij tekst z obrazu w jednej linii
Ten przykład pokazuje, jak łatwo zrozumieć IronOCR - tylko jedna linia C# zamienia twój obraz w tekst. Demonstruje inicjowanie silnika OCR i natychmiastowe odczytywanie oraz pobieranie tekstu bez złożonej konfiguracji.
1Install IronOCR with NuGet Package Manager
PM > Install-Package IronOcr
Install-Package IronOcr
2Skopiuj i uruchom ten fragment kodu.
string text = new IronTesseract().Read("image.png").Text;
string text = new IronTesseract().Read("image.png").Text;
C#
3Wdrożenie do testowania w środowisku produkcyjnym
Użyj klasy IronTesseract, aby natychmiast odczytywać tekst z obrazów
Zastosuj filtry obrazu, aby poprawić dokładność OCR na skanach niskiej jakości
Przetwarzaj wiele języków za pomocą pakietów językowych do pobrania
Eksportuj wyniki jako przeszukiwalne pliki PDF lub wyodrębnij ciągi tekstowe
Jak odczytać tekst z obrazów w aplikacjach .NET?
Aby osiągnąć funkcjonalność OCR C# konwersji obrazu na tekst w aplikacjach .NET, potrzebujesz niezawodnej biblioteki OCR. IronOCR dostarcza zarządzane rozwiązanie z wykorzystaniem klasy IronOcr.IronTesseract, która maksymalizuje zarówno dokładność, jak i szybkość bez potrzeby zewnętrznych zależności.
Dlaczego warto wybrać IronOCR do OCR w C# bez Tesseracta?
Kiedy potrzebujesz konwersji obrazów na tekst w C#, IronOCR oferuje znaczące zalety w porównaniu z tradycyjnymi wdrożeniami Tesseract:
Działa natychmiast w czystych środowiskach .NET
Nie wymaga instalacji ani konfiguracji Tesseract
Uruchamia najnowsze silniki: Tesseract 5 (plus Tesseract 4 i 3)
Kompatybilny z .NET Framework 4.6.2+, .NET Standard 2+, oraz .NET Core 2, 3, 5, 6, 7, 8, 9 i 10
Poprawia dokładność i prędkość w porównaniu z czystym Tesseract
Wspiera wdrożenia Xamarin, Mono, Azure i Docker
Zarządza złożonymi słownikami Tesseract poprzez pakiety NuGet
Automatycznie obsługuje pliki PDF, MultiFrame TIFF oraz wszystkie główne formaty obrazów
Koryguje skany niskiej jakości i przekrzywione dla optymalnych rezultatów
Jak używać samouczka IronOCR C# do podstawowego OCR?
Ten przykład C# Iron Tesseract pokazuje najprostszy sposób na odczytywanie tekstu z obrazu z użyciem IronOCR. Klasa IronOcr.IronTesseract wyodrębnia tekst i zwraca go jako ciąg znaków.
using IronOcr;IronTesseract ocr = new IronTesseract();using OcrInput input = new OcrInput();var pageindices = new int[] { 1, 2 };input.LoadImageFrames(@"img\Potter.LowQuality.tiff", pageindices);input.Deskew(); // removes rotation and perspectiveOcrResult result = ocr.Read(input);Console.WriteLine(result.Text);
using IronOcr;

IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames(@"img\Potter.LowQuality.tiff", pageindices);
input.Deskew(); // removes rotation and perspective
OcrResult result = ocr.Read(input);
Console.WriteLine(result.Text);
ImportsIronOcrPrivate ocr As New IronTesseract()PrivateOcrInputAsusingPrivate pageindices = New Integer() { 1, 2 }input.LoadImageFrames("img\Potter.LowQuality.tiff", pageindices)input.Deskew() ' removes rotation and perspectiveDim result AsOcrResult = ocr.Read(input)Console.WriteLine(result.Text)
Imports IronOcr

Private ocr As New IronTesseract()
Private OcrInput As using
Private pageindices = New Integer() { 1, 2 }
input.LoadImageFrames("img\Potter.LowQuality.tiff", pageindices)
input.Deskew() ' removes rotation and perspective
Dim result As OcrResult = ocr.Read(input)
Console.WriteLine(result.Text)
Ten kod osiąga 100% dokładność na klarownych obrazach, wyodrębniając tekst dokładnie tak, jak się pojawia:
IronOCR Simple ExampleIn this simple example we test the accuracy of our C# OCR library to read text from a PNG Image. This is a very basic test, but things will get more complicated as the tutorial continues.The quick brown fox jumps over the lazy dog
IronOCR Simple Example

In this simple example we test the accuracy of our C# OCR library to read text from a PNG Image. This is a very basic test, but things will get more complicated as the tutorial continues.

The quick brown fox jumps over the lazy dog
Text
Klasa IronTesseract obsługuje wewnętrznie skomplikowane operacje OCR. Automatycznie skanuje wyrównanie, optymalizuje rozdzielczość i używa AI do odczytywania tekstu z obrazu za pomocą IronOCR z dokładnością na poziomie ludzkim.
Pomimo skomplikowanego przetwarzania, które odbywa się w tle - w tym analizy obrazu, optymalizacji silnika i inteligentnego rozpoznawania tekstu - proces OCR dopasowuje się do szybkości czytania przez człowieka, utrzymując wyjątkowe poziomy dokładności.
Zrzut ekranu demonstrujący zdolność IronOCR do wyodrębniania tekstu z obrazu PNG z perfekcyjną dokładnością
Jak wdrożyć zaawansowane OCR C# bez konfiguracji Tesseracta?
Dla aplikacji produkcyjnych wymagających optymalnej wydajności przy konwersji obrazów do tekstu w C#, używaj klas OcrInput i IronTesseract razem. To podejście zapewnia szczegółową kontrolę nad procesem OCR.
Klasa OcrInput Funkcjonalności
Przetwarza wiele formatów obrazów: JPEG, TIFF, GIF, BMP, PNG
Importuje kompletne PDF-y lub określone strony
Poprawia kontrast, rozdzielczość i jakość obrazu automatycznie
Koryguje obrót, szumy skanowania, przekrzywienie i obrazy negatywowe
Klasa IronTesseract Funkcjonalności
Dostęp do ponad 127 gotowych pakietów językowych
Zawiera silniki Tesseract 5, 4 i 3
Specyfikacja typu dokumentu (zrzut ekranu, fragment lub pełny dokument)
Zintegrowane funkcje odczytu BarCODE
Wiele formatów wyjściowych: pliki PDF z możliwością wyszukiwania, HOCR HTML, obiekty DOM i ciągi znaków
Jak zacząć z OcrInput i IronTesseract?
Oto zalecana konfiguracja dla tego samouczka IronOCR C#, która działa dobrze z większością typów dokumentów:
using IronOcr;using IronSoftware.Drawing;IronTesseract ocr = new IronTesseract();using OcrInput input = new OcrInput();// restrict OCR to a content area for faster processingRectangle contentArea = new Rectangle(x: 215, y: 1250, height: 280, width: 1335);input.LoadImage("img/ComSci.png", contentArea);OcrResult result = ocr.Read(input);Console.WriteLine(result.Text);
using IronOcr;
using IronSoftware.Drawing;

IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
// restrict OCR to a content area for faster processing
Rectangle contentArea = new Rectangle(x: 215, y: 1250, height: 280, width: 1335);
input.LoadImage("img/ComSci.png", contentArea);
OcrResult result = ocr.Read(input);
Console.WriteLine(result.Text);
C#
Ta konfiguracja konsekwentnie zapewnia niemal idealną dokładność w przypadku skanów o średniej jakości. Metoda LoadImageFrames efektywnie obsługuje dokumenty wielostronicowe, co czyni ją idealną dla scenariuszy przetwarzania wsadowego.
Przykładowy dokument TIFF pokazujący możliwości IronOCR w zakresie ekstrakcji tekstu z wielu stron
Możliwość odczytu tekstu z obrazów i BARCODE-ów w zeskanowanych dokumentach, takich jak pliki TIFF, pokazuje, w jaki sposób IronOCR upraszcza złożone zadania OCR. Biblioteka doskonale radzi sobie z dokumentami z życia codziennego, płynnie obsługując wielostronicowe pliki TIFF i wyodrębnianie tekstu z plików PDF.
Jak IronOCR radzi sobie ze skanami niskiej jakości?
Dokument o niskiej rozdzielczości z zakłóceniami, który IronOCR może dokładnie przetworzyć przy użyciu filtrów obrazu
W przypadku pracy z niedoskonałymi skanami zawierającymi zniekształcenia i szumy cyfrowe, biblioteka IronOCR przewyższa inne biblioteki OCR dla języka C#. Zostało zaprojektowane specjalnie z myślą o rzeczywistych scenariuszach, a nie idealnych obrazach testowych.
// PM> Install IronOcr.Languages.Arabicusing IronOcr;IronTesseract ocr = new IronTesseract();ocr.Language = OcrLanguage.Arabic;using OcrInput input = new OcrInput();input.LoadImageFrame("img/arabic.gif", 1);// add image filters if needed// In this case, even thought input is very low quality// IronTesseract can read what conventional Tesseract cannot.OcrResult result = ocr.Read(input);// Console can't print Arabic on Windows easily.// Let's save to disk instead.result.SaveAsTextFile("arabic.txt");
// PM> Install IronOcr.Languages.Arabic
using IronOcr;

IronTesseract ocr = new IronTesseract();
ocr.Language = OcrLanguage.Arabic;

using OcrInput input = new OcrInput();
input.LoadImageFrame("img/arabic.gif", 1);
// add image filters if needed
// In this case, even thought input is very low quality
// IronTesseract can read what conventional Tesseract cannot.

OcrResult result = ocr.Read(input);

// Console can't print Arabic on Windows easily.
// Let's save to disk instead.
result.SaveAsTextFile("arabic.txt");
' PM> Install IronOcr.Languages.ArabicImportsIronOcrPrivate ocr As New IronTesseract()ocr.Language = OcrLanguage.ArabicUsing input As New OcrInput() input.LoadImageFrame("img/arabic.gif", 1) ' add image filters if needed ' In this case, even thought input is very low quality ' IronTesseract can read what conventional Tesseract cannot. Dim result AsOcrResult = ocr.Read(input) ' Console can't print Arabic on Windows easily. ' Let's save to disk instead. result.SaveAsTextFile("arabic.txt")EndUsing
' PM> Install IronOcr.Languages.Arabic
Imports IronOcr

Private ocr As New IronTesseract()
ocr.Language = OcrLanguage.Arabic

Using input As New OcrInput()
	input.LoadImageFrame("img/arabic.gif", 1)
	' add image filters if needed
	' In this case, even thought input is very low quality
	' IronTesseract can read what conventional Tesseract cannot.

	Dim result As OcrResult = ocr.Read(input)

	' Console can't print Arabic on Windows easily.
	' Let's save to disk instead.
	result.SaveAsTextFile("arabic.txt")
End Using
Użycie Input.Deskew() poprawia dokładność do 99,8% na skanach niskiej jakości, co prawie dorównuje wynikom wysokiej jakości. To pokazuje, dlaczego IronOCR jest preferowanym wyborem dla OCR w C# bez komplikacji związanych z Tesseractem.
Filtry obrazów mogą nieznacznie wydłużyć czas przetwarzania, ale znacznie skrócą całkowity czas trwania OCR. Znalezienie odpowiedniej równowagi zależy od jakości dokumentu.
Dla większości scenariuszy, Input.Deskew() i Input.DeNoise() zapewniają niezawodne poprawki wydajności OCR. Dowiedz się więcej o technikach wstępnego przetwarzania obrazów.
Jak zoptymalizować wydajność i szybkość OCR?
Najważniejszym czynnikiem wpływającym na szybkość OCR podczas konwersji obrazów na tekst w języku C# jest jakość danych wejściowych. Wyższa rozdzielczość (około 200 dpi) przy minimalnym poziomie szumu zapewnia najszybsze i najdokładniejsze wyniki.
Chociaż IronOCR doskonale radzi sobie z poprawianiem dokumentów zawierających błędy, to ulepszenie wymaga dodatkowego czasu przetwarzania.
Wybierz formaty obrazów z minimalnymi artefaktami kompresji. Formaty TIFF i PNG zazwyczaj zapewniają szybsze wyniki niż JPEG ze względu na mniejszy poziom szumu cyfrowego.
Które filtry obrazu zwiększają szybkość OCR?
Następujące filtry mogą znacznie poprawić wydajność procesu przekształcania obrazów w tekst w języku C# przy użyciu OCR:
OcrInput.Rotate(double degrees): Obraca obrazy zgodnie z ruchem wskazówek zegara (ujemnie dla przeciwnie do ruchu wskazówek)
OcrInput.Binarize(): Konwertuje do czarno-białego, poprawiając wydajność przy niskim kontraście
OcrInput.ToGrayScale(): Konwertuje do skali szarości dla potencjalnej poprawy szybkości
OcrInput.Contrast(): Automatycznie dostosowuje kontrast dla lepszej dokładności
OcrInput.DeNoise(): Usuwa cyfrowe artefakty, gdy przewidywany jest szum
OcrInput.Invert(): Odwraca kolory dla białego tekstu na czarnym tle
OcrInput.Dilate(): Rozszerza granice tekstu
OcrInput.Erode(): Zmniejsza granice tekstu
OcrInput.Deskew(): Korekta wyrównania - kluczowe dla przekrzywionych dokumentów
OcrInput.EnhanceResolution: Poprawia jakość obrazów o niskiej rozdzielczości
OcrInput.DetectPageOrientation(): Wykrywa i koryguje obrót strony. Przekaż OrientationDetectionMode, aby kontrolować kompromis między dokładnością a szybkością: Fast, Balanced, Detailed lub ExtremeDetailed (dodano w v2025.8.6)
Scale() i EnhanceResolution() są niekompatybilne z SaveAsSearchablePdf() z powodu znanego problemu w v2025.12.3. Wszystkie inne filtry działają poprawnie przy produkcji przeszukiwalnego PDF.
Jak skonfigurować IronOCR, aby uzyskać maksymalną prędkość?
Użyj tych ustawień, aby zoptymalizować szybkość przetwarzania skanów o wysokiej jakości:
using IronOcr;IronTesseract ocr = new IronTesseract();ocr.Language = OcrLanguage.ChineseSimplified;// We can add any number of languages.ocr.AddSecondaryLanguage(OcrLanguage.English);// Optionally add custom tesseract .traineddata files by specifying a file pathusing OcrInput input = new OcrInput();input.LoadImage("img/MultiLanguage.jpeg");OcrResult result = ocr.Read(input);result.SaveAsTextFile("MultiLanguage.txt");
using IronOcr;

IronTesseract ocr = new IronTesseract();
ocr.Language = OcrLanguage.ChineseSimplified;

// We can add any number of languages.
ocr.AddSecondaryLanguage(OcrLanguage.English);
// Optionally add custom tesseract .traineddata files by specifying a file path

using OcrInput input = new OcrInput();
input.LoadImage("img/MultiLanguage.jpeg");
OcrResult result = ocr.Read(input);
result.SaveAsTextFile("MultiLanguage.txt");
ImportsIronOcrPrivate ocr As New IronTesseract()ocr.Language = OcrLanguage.ChineseSimplified' We can add any number of languages.ocr.AddSecondaryLanguage(OcrLanguage.English)' Optionally add custom tesseract .traineddata files by specifying a file pathUsing input As New OcrInput() input.LoadImage("img/MultiLanguage.jpeg") Dim result AsOcrResult = ocr.Read(input) result.SaveAsTextFile("MultiLanguage.txt")EndUsing
Imports IronOcr

Private ocr As New IronTesseract()
ocr.Language = OcrLanguage.ChineseSimplified

' We can add any number of languages.
ocr.AddSecondaryLanguage(OcrLanguage.English)
' Optionally add custom tesseract .traineddata files by specifying a file path

Using input As New OcrInput()
	input.LoadImage("img/MultiLanguage.jpeg")
	Dim result As OcrResult = ocr.Read(input)
	result.SaveAsTextFile("MultiLanguage.txt")
End Using
Ta zoptymalizowana konfiguracja zapewnia 99,8% dokładności przy jednoczesnym 35-procentowym przyspieszeniu w porównaniu z ustawieniami domyślnymi.
Jak czytać określone obszary obrazów, używając OCR w C#?
Poniższy przykład w Iron Tesseract C# pokazuje, jak kierować się do określonych regionów za pomocą System.Drawing.Rectangle. Technika ta jest nieoceniona przy przetwarzaniu standardowych formularzy, w których tekst pojawia się w przewidywalnych miejscach.
Czy IronOCR może przetwarzać przycięte obszary w celu uzyskania szybszych wyników?
Korzystając ze współrzędnych opartych na pikselach, można ograniczyć działanie OCR do określonych obszarów, co znacznie poprawia szybkość i zapobiega niepożądanemu wyodrębnianiu tekstu:
using IronOcr;IronTesseract ocr = new IronTesseract();using OcrInput input = new OcrInput();input.LoadImage("image1.jpeg");input.LoadImage("image2.png");var pageindices = new int[] { 1, 2 };input.LoadImageFrames("image3.gif", pageindices);OcrResult result = ocr.Read(input);Console.WriteLine($"{result.Pages.Length} Pages"); // 3 Pages
using IronOcr;

IronTesseract ocr = new IronTesseract();

using OcrInput input = new OcrInput();
input.LoadImage("image1.jpeg");
input.LoadImage("image2.png");
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames("image3.gif", pageindices);

OcrResult result = ocr.Read(input);

Console.WriteLine($"{result.Pages.Length} Pages"); // 3 Pages
ImportsIronOcrPrivate ocr As New IronTesseract()PrivateOcrInputAsusinginput.LoadImage("image1.jpeg")input.LoadImage("image2.png")Dim pageindices = New Integer() { 1, 2 }input.LoadImageFrames("image3.gif", pageindices)Dim result AsOcrResult = ocr.Read(input)Console.WriteLine($"{result.Pages.Length} Pages") ' 3 Pages
Imports IronOcr

Private ocr As New IronTesseract()

Private OcrInput As using
input.LoadImage("image1.jpeg")
input.LoadImage("image2.png")
Dim pageindices = New Integer() { 1, 2 }
input.LoadImageFrames("image3.gif", pageindices)

Dim result As OcrResult = ocr.Read(input)

Console.WriteLine($"{result.Pages.Length} Pages") ' 3 Pages
To ukierunkowane podejście zapewnia 41% wzrost szybkości przy wyodrębnianiu wyłącznie istotnego tekstu. Idealnie nadaje się do dokumentów o ustalonej strukturze, takich jak faktury, czeki i formularze. Ta sama technika przycinania działa płynnie w operacjach OCR plików PDF.
Dokument pokazujący precyzyjne wyodrębnianie tekstu na podstawie regionu przy użyciu zaznaczenia prostokątnego w IronOCR
Ile języków obsługuje IronOCR?
IronOCR oferuje 127 języków międzynarodowych w postaci wygodnych pakietów językowych. Pobierz je jako pliki DLL z naszej strony internetowej lub za pośrednictwem menedżera pakietów NuGet.
Obsługiwane języki to arabski, chiński (uproszczony/tradycyjny), japoński, koreański, hindi, rosyjski, niemiecki, francuski, hiszpański oraz ponad 115 innych, z których każdy jest zoptymalizowany pod kątem dokładnego rozpoznawania tekstu.
Jak wdrożyć OCR w wielu językach?
Ten przykładowy samouczek IronOCR w języku C# pokazuje rozpoznawanie tekstu arabskiego:
PM > Install-Package IronOcr.Languages.Arabic
Install-Package IronOcr.Languages.Arabic
IronOCR dokładnie wyodrębnia tekst arabski z obrazu GIF
using IronOcr;IronTesseract ocr = new IronTesseract();using OcrInput input = new OcrInput();input.LoadPdf("example.pdf", Password: "password");// We can also select specific PDF page numbers to OCROcrResult result = ocr.Read(input);Console.WriteLine(result.Text);Console.WriteLine($"{result.Pages.Length} Pages");// 1 page for every page of the PDF
using IronOcr;

IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
input.LoadPdf("example.pdf", Password: "password");
// We can also select specific PDF page numbers to OCR

OcrResult result = ocr.Read(input);

Console.WriteLine(result.Text);
Console.WriteLine($"{result.Pages.Length} Pages");
// 1 page for every page of the PDF
ImportsIronOcrPrivate ocr As New IronTesseract()PrivateOcrInputAsusinginput.LoadPdf("example.pdf", Password:= "password")' We can also select specific PDF page numbers to OCRDim result AsOcrResult = ocr.Read(input)Console.WriteLine(result.Text)Console.WriteLine($"{result.Pages.Length} Pages")' 1 page for every page of the PDF
Imports IronOcr

Private ocr As New IronTesseract()
Private OcrInput As using
input.LoadPdf("example.pdf", Password:= "password")
' We can also select specific PDF page numbers to OCR

Dim result As OcrResult = ocr.Read(input)

Console.WriteLine(result.Text)
Console.WriteLine($"{result.Pages.Length} Pages")
' 1 page for every page of the PDF
Czy IronOCR obsługuje dokumenty w wielu językach?
Jeśli dokumenty zawierają różne języki, skonfiguruj IronOCR do obsługi wielu języków:
using IronOcr;IronTesseract ocr = new IronTesseract();using OcrInput input = new OcrInput();input.Title = "Pdf Metadata Name";input.LoadPdf("example.pdf", Password: "password");OcrResult result = ocr.Read(input);result.SaveAsSearchablePdf("searchable.pdf");
using IronOcr;

IronTesseract ocr = new IronTesseract();

using OcrInput input = new OcrInput();
input.Title = "Pdf Metadata Name";
input.LoadPdf("example.pdf", Password: "password");
OcrResult result = ocr.Read(input);
result.SaveAsSearchablePdf("searchable.pdf");
ImportsIronOcrPrivate ocr As New IronTesseract()PrivateOcrInputAsusinginput.Title = "Pdf Metadata Name"input.LoadPdf("example.pdf", Password:= "password")Dim result AsOcrResult = ocr.Read(input)result.SaveAsSearchablePdf("searchable.pdf")
Imports IronOcr

Private ocr As New IronTesseract()

Private OcrInput As using
input.Title = "Pdf Metadata Name"
input.LoadPdf("example.pdf", Password:= "password")
Dim result As OcrResult = ocr.Read(input)
result.SaveAsSearchablePdf("searchable.pdf")
Jak przetwarzać dokumenty wielostronicowe za pomocą OCR w C#?
IronOCR płynnie łączy wiele stron lub obrazów w pojedynczy OcrResult. Ta funkcja zapewnia zaawansowane możliwości, takie jak tworzenie plików PDF z funkcją wyszukiwania oraz wyodrębnianie tekstu z całych zestawów dokumentów.
Łącz i dopasowuj różne źródła - obrazy, ramki TIFF i strony PDF - w ramach jednej operacji OCR:
using IronOcr;IronTesseract ocr = new IronTesseract();using OcrInput input = new OcrInput();input.Title = "Pdf Title";var pageindices = new int[] { 1, 2 };input.LoadImageFrames("example.tiff", pageindices);OcrResult result = ocr.Read(input);result.SaveAsSearchablePdf("searchable.pdf");
using IronOcr;

IronTesseract ocr = new IronTesseract();
using OcrInput input = new OcrInput();
input.Title = "Pdf Title";
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames("example.tiff", pageindices);
OcrResult result = ocr.Read(input);
result.SaveAsSearchablePdf("searchable.pdf");
ImportsIronOcrPrivate ocr As New IronTesseract()PrivateOcrInputAsusinginput.Title = "Pdf Title"Dim pageindices = New Integer() { 1, 2 }input.LoadImageFrames("example.tiff", pageindices)Dim result AsOcrResult = ocr.Read(input)result.SaveAsSearchablePdf("searchable.pdf")
Imports IronOcr

Private ocr As New IronTesseract()
Private OcrInput As using
input.Title = "Pdf Title"
Dim pageindices = New Integer() { 1, 2 }
input.LoadImageFrames("example.tiff", pageindices)
Dim result As OcrResult = ocr.Read(input)
result.SaveAsSearchablePdf("searchable.pdf")
Wydajne przetwarzanie wszystkich stron pliku TIFF:
using IronOcr;IronTesseract ocr = new IronTesseract();using OcrInput input = new OcrInput();input.Title = "Html Title";// Add more content as required...input.LoadImage("image2.jpeg");input.LoadPdf("example.pdf",Password: "password");var pageindices = new int[] { 1, 2 };input.LoadImageFrames("example.tiff", pageindices);OcrResult result = ocr.Read(input);result.SaveAsHocrFile("hocr.html");
using IronOcr;

IronTesseract ocr = new IronTesseract();

using OcrInput input = new OcrInput();
input.Title = "Html Title";

// Add more content as required...
input.LoadImage("image2.jpeg");
input.LoadPdf("example.pdf",Password: "password");
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames("example.tiff", pageindices);

OcrResult result = ocr.Read(input);
result.SaveAsHocrFile("hocr.html");
ImportsIronOcrPrivate ocr As New IronTesseract()PrivateOcrInputAsusinginput.Title = "Html Title"' Add more content as required...input.LoadImage("image2.jpeg")input.LoadPdf("example.pdf",Password:= "password")Dim pageindices = New Integer() { 1, 2 }input.LoadImageFrames("example.tiff", pageindices)Dim result AsOcrResult = ocr.Read(input)result.SaveAsHocrFile("hocr.html")
Imports IronOcr

Private ocr As New IronTesseract()

Private OcrInput As using
input.Title = "Html Title"

' Add more content as required...
input.LoadImage("image2.jpeg")
input.LoadPdf("example.pdf",Password:= "password")
Dim pageindices = New Integer() { 1, 2 }
input.LoadImageFrames("example.tiff", pageindices)

Dim result As OcrResult = ocr.Read(input)
result.SaveAsHocrFile("hocr.html")
Konwertuj pliki TIFF lub PDF do formatów umożliwiających wyszukiwanie:
using IronOcr;IronTesseract ocr = new IronTesseract();ocr.Configuration.ReadBarCodes = true;using OcrInput input = new OcrInput();input.LoadImage("img/Barcode.png");OcrResult result = ocr.Read(input);foreach (var barcode in result.Barcodes){Console.WriteLine(barcode.Value); // type and location properties also exposed}
using IronOcr;

IronTesseract ocr = new IronTesseract();

ocr.Configuration.ReadBarCodes = true;

using OcrInput input = new OcrInput();
input.LoadImage("img/Barcode.png");

OcrResult result = ocr.Read(input);

foreach (var barcode in result.Barcodes)
{
    Console.WriteLine(barcode.Value);
    // type and location properties also exposed
}
ImportsIronOcrPrivate ocr As New IronTesseract()ocr.Configuration.ReadBarCodes = TrueUsing input As New OcrInput() input.LoadImage("img/Barcode.png") Dim result AsOcrResult = ocr.Read(input) For Each barcode In result.BarcodesConsole.WriteLine(barcode.Value) ' type and location properties also exposed Next barcodeEndUsing
Imports IronOcr

Private ocr As New IronTesseract()

ocr.Configuration.ReadBarCodes = True

Using input As New OcrInput()
	input.LoadImage("img/Barcode.png")

	Dim result As OcrResult = ocr.Read(input)

	For Each barcode In result.Barcodes
		Console.WriteLine(barcode.Value)
		' type and location properties also exposed
	Next barcode
End Using
Konwersja istniejących plików PDF do wersji z możliwością wyszukiwania:
using IronOcr;using IronSoftware.Drawing;// We can delve deep into OCR results as an object model of Pages, Barcodes, Paragraphs, Lines, Words and Characters// This allows us to explore, export and draw OCR content using other APIsIronTesseract ocr = new IronTesseract();ocr.Configuration.ReadBarCodes = true;using OcrInput input = new OcrInput();var pageindices = new int[] { 1, 2 };input.LoadImageFrames(@"img\Potter.tiff", pageindices);OcrResult result = ocr.Read(input);foreach (var page in result.Pages){ // Page object int pageNumber = page.PageNumber; string pageText = page.Text; int pageWordCount = page.WordCount; // null if we don't set Ocr.Configuration.ReadBarCodes = true; OcrResult.Barcode[] barcodes = page.Barcodes; AnyBitmap pageImage = page.ToBitmap(input); System.Drawing.Bitmap pageImageLegacy = page.ToBitmap(input); double pageWidth = page.Width; double pageHeight = page.Height; foreach (var paragraph in page.Paragraphs) { // Pages -> Paragraphs int paragraphNumber = paragraph.ParagraphNumber; String paragraphText = paragraph.Text; System.Drawing.Bitmap paragraphImage = paragraph.ToBitmap(input); int paragraphXLocation = paragraph.X; int paragraphYLocation = paragraph.Y; int paragraphWidth = paragraph.Width; int paragraphHeight = paragraph.Height; double paragraphOcrAccuracy = paragraph.Confidence; var paragraphTextDirection = paragraph.TextDirection; foreach (var line in paragraph.Lines) { // Pages -> Paragraphs -> Lines int lineNumber = line.LineNumber; String lineText = line.Text; AnyBitmap lineImage = line.ToBitmap(input); System.Drawing.Bitmap lineImageLegacy = line.ToBitmap(input); int lineXLocation = line.X; int lineYLocation = line.Y; int lineWidth = line.Width; int lineHeight = line.Height; double lineOcrAccuracy = line.Confidence; double lineSkew = line.BaselineAngle; double lineOffset = line.BaselineOffset; foreach (var word in line.Words) { // Pages -> Paragraphs -> Lines -> Words int wordNumber = word.WordNumber; String wordText = word.Text; AnyBitmap wordImage = word.ToBitmap(input); System.Drawing.Image wordImageLegacy = word.ToBitmap(input); int wordXLocation = word.X; int wordYLocation = word.Y; int wordWidth = word.Width; int wordHeight = word.Height; double wordOcrAccuracy = word.Confidence; if (word.Font != null) { // Word.Font is only set when using Tesseract Engine Modes rather than LTSM String fontName = word.Font.FontName; double fontSize = word.Font.FontSize; bool isBold = word.Font.IsBold; bool isFixedWidth = word.Font.IsFixedWidth; bool isItalic = word.Font.IsItalic; bool isSerif = word.Font.IsSerif; bool isUnderlined = word.Font.IsUnderlined; bool fontIsCaligraphic = word.Font.IsCaligraphic; } foreach (var character in word.Characters) { // Pages -> Paragraphs -> Lines -> Words -> Characters int characterNumber = character.CharacterNumber; String characterText = character.Text; AnyBitmap characterImage = character.ToBitmap(input); System.Drawing.Bitmap characterImageLegacy = character.ToBitmap(input); int characterXLocation = character.X; int characterYLocation = character.Y; int characterWidth = character.Width; int characterHeight = character.Height; double characterOcrAccuracy = character.Confidence; // Output alternative symbols choices and their probability. // Very useful for spell checking OcrResult.Choice[] characterChoices = character.Choices; } } } }}
using IronOcr;
using IronSoftware.Drawing;

// We can delve deep into OCR results as an object model of Pages, Barcodes, Paragraphs, Lines, Words and Characters
// This allows us to explore, export and draw OCR content using other APIs

IronTesseract ocr = new IronTesseract();
ocr.Configuration.ReadBarCodes = true;

using OcrInput input = new OcrInput();
var pageindices = new int[] { 1, 2 };
input.LoadImageFrames(@"img\Potter.tiff", pageindices);

OcrResult result = ocr.Read(input);

foreach (var page in result.Pages)
{
    // Page object
    int pageNumber = page.PageNumber;
    string pageText = page.Text;
    int pageWordCount = page.WordCount;

    // null if we don't set Ocr.Configuration.ReadBarCodes = true;
    OcrResult.Barcode[] barcodes = page.Barcodes;

    AnyBitmap pageImage = page.ToBitmap(input);
    System.Drawing.Bitmap pageImageLegacy = page.ToBitmap(input);
    double pageWidth = page.Width;
    double pageHeight = page.Height;

    foreach (var paragraph in page.Paragraphs)
    {
        // Pages -> Paragraphs
        int paragraphNumber = paragraph.ParagraphNumber;
        String paragraphText = paragraph.Text;
        System.Drawing.Bitmap paragraphImage = paragraph.ToBitmap(input);
        int paragraphXLocation = paragraph.X;
        int paragraphYLocation = paragraph.Y;
        int paragraphWidth = paragraph.Width;
        int paragraphHeight = paragraph.Height;
        double paragraphOcrAccuracy = paragraph.Confidence;
        var paragraphTextDirection = paragraph.TextDirection;

        foreach (var line in paragraph.Lines)
        {
            // Pages -> Paragraphs -> Lines
            int lineNumber = line.LineNumber;
            String lineText = line.Text;
            AnyBitmap lineImage = line.ToBitmap(input);
            System.Drawing.Bitmap lineImageLegacy = line.ToBitmap(input);
            int lineXLocation = line.X;
            int lineYLocation = line.Y;
            int lineWidth = line.Width;
            int lineHeight = line.Height;
            double lineOcrAccuracy = line.Confidence;
            double lineSkew = line.BaselineAngle;
            double lineOffset = line.BaselineOffset;

            foreach (var word in line.Words)
            {
                // Pages -> Paragraphs -> Lines -> Words
                int wordNumber = word.WordNumber;
                String wordText = word.Text;
                AnyBitmap wordImage = word.ToBitmap(input);
                System.Drawing.Image wordImageLegacy = word.ToBitmap(input);
                int wordXLocation = word.X;
                int wordYLocation = word.Y;
                int wordWidth = word.Width;
                int wordHeight = word.Height;
                double wordOcrAccuracy = word.Confidence;

                if (word.Font != null)
                {
                    // Word.Font is only set when using Tesseract Engine Modes rather than LTSM
                    String fontName = word.Font.FontName;
                    double fontSize = word.Font.FontSize;
                    bool isBold = word.Font.IsBold;
                    bool isFixedWidth = word.Font.IsFixedWidth;
                    bool isItalic = word.Font.IsItalic;
                    bool isSerif = word.Font.IsSerif;
                    bool isUnderlined = word.Font.IsUnderlined;
                    bool fontIsCaligraphic = word.Font.IsCaligraphic;
                }

                foreach (var character in word.Characters)
                {
                    // Pages -> Paragraphs -> Lines -> Words -> Characters
                    int characterNumber = character.CharacterNumber;
                    String characterText = character.Text;
                    AnyBitmap characterImage = character.ToBitmap(input);
                    System.Drawing.Bitmap characterImageLegacy = character.ToBitmap(input);
                    int characterXLocation = character.X;
                    int characterYLocation = character.Y;
                    int characterWidth = character.Width;
                    int characterHeight = character.Height;
                    double characterOcrAccuracy = character.Confidence;

                    // Output alternative symbols choices and their probability.
                    // Very useful for spell checking
                    OcrResult.Choice[] characterChoices = character.Choices;
                }
            }
        }
    }
}
ImportsIronOcrImportsIronSoftware.Drawing' We can delve deep into OCR results as an object model of Pages, Barcodes, Paragraphs, Lines, Words and Characters' This allows us to explore, export and draw OCR content using other APIsPrivate ocr As New IronTesseract()ocr.Configuration.ReadBarCodes = TrueUsing input As New OcrInput() Dim pageindices = New Integer() { 1, 2 } input.LoadImageFrames("img\Potter.tiff", pageindices) Dim result AsOcrResult = ocr.Read(input) For Each page In result.Pages ' Page object Dim pageNumber AsInteger = page.PageNumber Dim pageText AsString = page.Text Dim pageWordCount AsInteger = page.WordCount ' null if we don't set Ocr.Configuration.ReadBarCodes = true; Dim barcodes() AsOcrResult.Barcode = page.Barcodes Dim pageImage AsAnyBitmap = page.ToBitmap(input) Dim pageImageLegacy AsSystem.Drawing.Bitmap = page.ToBitmap(input) Dim pageWidth AsDouble = page.Width Dim pageHeight AsDouble = page.Height For Each paragraph In page.Paragraphs ' Pages -> Paragraphs Dim paragraphNumber AsInteger = paragraph.ParagraphNumber Dim paragraphText AsString = paragraph.Text Dim paragraphImage AsSystem.Drawing.Bitmap = paragraph.ToBitmap(input) Dim paragraphXLocation AsInteger = paragraph.X Dim paragraphYLocation AsInteger = paragraph.Y Dim paragraphWidth AsInteger = paragraph.Width Dim paragraphHeight AsInteger = paragraph.Height Dim paragraphOcrAccuracy AsDouble = paragraph.Confidence Dim paragraphTextDirection = paragraph.TextDirection For Each line In paragraph.Lines ' Pages -> Paragraphs -> Lines Dim lineNumber AsInteger = line.LineNumber Dim lineText AsString = line.Text Dim lineImage AsAnyBitmap = line.ToBitmap(input) Dim lineImageLegacy AsSystem.Drawing.Bitmap = line.ToBitmap(input) Dim lineXLocation AsInteger = line.X Dim lineYLocation AsInteger = line.Y Dim lineWidth AsInteger = line.Width Dim lineHeight AsInteger = line.Height Dim lineOcrAccuracy AsDouble = line.Confidence Dim lineSkew AsDouble = line.BaselineAngle Dim lineOffset AsDouble = line.BaselineOffset For Each word In line.Words ' Pages -> Paragraphs -> Lines -> Words Dim wordNumber AsInteger = word.WordNumber Dim wordText AsString = word.Text Dim wordImage AsAnyBitmap = word.ToBitmap(input) Dim wordImageLegacy AsSystem.Drawing.Image = word.ToBitmap(input) Dim wordXLocation AsInteger = word.X Dim wordYLocation AsInteger = word.Y Dim wordWidth AsInteger = word.Width Dim wordHeight AsInteger = word.Height Dim wordOcrAccuracy AsDouble = word.Confidence If word.FontIsNot Nothing Then ' Word.Font is only set when using Tesseract Engine Modes rather than LTSM Dim fontName AsString = word.Font.FontName Dim fontSize AsDouble = word.Font.FontSize Dim isBold AsBoolean = word.Font.IsBold Dim isFixedWidth AsBoolean = word.Font.IsFixedWidth Dim isItalic AsBoolean = word.Font.IsItalic Dim isSerif AsBoolean = word.Font.IsSerif Dim isUnderlined AsBoolean = word.Font.IsUnderlined Dim fontIsCaligraphic AsBoolean = word.Font.IsCaligraphic End If For Each character In word.Characters ' Pages -> Paragraphs -> Lines -> Words -> Characters Dim characterNumber AsInteger = character.CharacterNumber Dim characterText AsString = character.Text Dim characterImage AsAnyBitmap = character.ToBitmap(input) Dim characterImageLegacy AsSystem.Drawing.Bitmap = character.ToBitmap(input) Dim characterXLocation AsInteger = character.X Dim characterYLocation AsInteger = character.Y Dim characterWidth AsInteger = character.Width Dim characterHeight AsInteger = character.Height Dim characterOcrAccuracy AsDouble = character.Confidence ' Output alternative symbols choices and their probability. ' Very useful for spell checking Dim characterChoices() AsOcrResult.Choice = character.Choices Next character Next word Next line Next paragraph Next pageEndUsing
Imports IronOcr
Imports IronSoftware.Drawing

' We can delve deep into OCR results as an object model of Pages, Barcodes, Paragraphs, Lines, Words and Characters
' This allows us to explore, export and draw OCR content using other APIs

Private ocr As New IronTesseract()
ocr.Configuration.ReadBarCodes = True

Using input As New OcrInput()
	Dim pageindices = New Integer() { 1, 2 }
	input.LoadImageFrames("img\Potter.tiff", pageindices)

	Dim result As OcrResult = ocr.Read(input)

	For Each page In result.Pages
		' Page object
		Dim pageNumber As Integer = page.PageNumber
		Dim pageText As String = page.Text
		Dim pageWordCount As Integer = page.WordCount

		' null if we don't set Ocr.Configuration.ReadBarCodes = true;
		Dim barcodes() As OcrResult.Barcode = page.Barcodes

		Dim pageImage As AnyBitmap = page.ToBitmap(input)
		Dim pageImageLegacy As System.Drawing.Bitmap = page.ToBitmap(input)
		Dim pageWidth As Double = page.Width
		Dim pageHeight As Double = page.Height

		For Each paragraph In page.Paragraphs
			' Pages -> Paragraphs
			Dim paragraphNumber As Integer = paragraph.ParagraphNumber
			Dim paragraphText As String = paragraph.Text
			Dim paragraphImage As System.Drawing.Bitmap = paragraph.ToBitmap(input)
			Dim paragraphXLocation As Integer = paragraph.X
			Dim paragraphYLocation As Integer = paragraph.Y
			Dim paragraphWidth As Integer = paragraph.Width
			Dim paragraphHeight As Integer = paragraph.Height
			Dim paragraphOcrAccuracy As Double = paragraph.Confidence
			Dim paragraphTextDirection = paragraph.TextDirection

			For Each line In paragraph.Lines
				' Pages -> Paragraphs -> Lines
				Dim lineNumber As Integer = line.LineNumber
				Dim lineText As String = line.Text
				Dim lineImage As AnyBitmap = line.ToBitmap(input)
				Dim lineImageLegacy As System.Drawing.Bitmap = line.ToBitmap(input)
				Dim lineXLocation As Integer = line.X
				Dim lineYLocation As Integer = line.Y
				Dim lineWidth As Integer = line.Width
				Dim lineHeight As Integer = line.Height
				Dim lineOcrAccuracy As Double = line.Confidence
				Dim lineSkew As Double = line.BaselineAngle
				Dim lineOffset As Double = line.BaselineOffset

				For Each word In line.Words
					' Pages -> Paragraphs -> Lines -> Words
					Dim wordNumber As Integer = word.WordNumber
					Dim wordText As String = word.Text
					Dim wordImage As AnyBitmap = word.ToBitmap(input)
					Dim wordImageLegacy As System.Drawing.Image = word.ToBitmap(input)
					Dim wordXLocation As Integer = word.X
					Dim wordYLocation As Integer = word.Y
					Dim wordWidth As Integer = word.Width
					Dim wordHeight As Integer = word.Height
					Dim wordOcrAccuracy As Double = word.Confidence

					If word.Font IsNot Nothing Then
						' Word.Font is only set when using Tesseract Engine Modes rather than LTSM
						Dim fontName As String = word.Font.FontName
						Dim fontSize As Double = word.Font.FontSize
						Dim isBold As Boolean = word.Font.IsBold
						Dim isFixedWidth As Boolean = word.Font.IsFixedWidth
						Dim isItalic As Boolean = word.Font.IsItalic
						Dim isSerif As Boolean = word.Font.IsSerif
						Dim isUnderlined As Boolean = word.Font.IsUnderlined
						Dim fontIsCaligraphic As Boolean = word.Font.IsCaligraphic
					End If

					For Each character In word.Characters
						' Pages -> Paragraphs -> Lines -> Words -> Characters
						Dim characterNumber As Integer = character.CharacterNumber
						Dim characterText As String = character.Text
						Dim characterImage As AnyBitmap = character.ToBitmap(input)
						Dim characterImageLegacy As System.Drawing.Bitmap = character.ToBitmap(input)
						Dim characterXLocation As Integer = character.X
						Dim characterYLocation As Integer = character.Y
						Dim characterWidth As Integer = character.Width
						Dim characterHeight As Integer = character.Height
						Dim characterOcrAccuracy As Double = character.Confidence

						' Output alternative symbols choices and their probability.
						' Very useful for spell checking
						Dim characterChoices() As OcrResult.Choice = character.Choices
					Next character
				Next word
			Next line
		Next paragraph
	Next page
End Using
Zastosuj tę samą technikę do konwersji plików TIFF:
using IronOcr;var ocr = new IronTesseract();using (var input = new OcrInput()){ // Configure document properties input.Title = "Scanned Archive Document"; // Select pages to process var pageIndices = new int[] { 1, 2 }; input.LoadImageFrames("example.tiff", pageIndices); // Create searchable PDF from TIFF OcrResult result = ocr.Read(input); result.SaveAsSearchablePdf("searchable.pdf");}
using IronOcr;

var ocr = new IronTesseract();

using (var input = new OcrInput())
{
    // Configure document properties
    input.Title = "Scanned Archive Document";

    // Select pages to process
    var pageIndices = new int[] { 1, 2 };
    input.LoadImageFrames("example.tiff", pageIndices);

    // Create searchable PDF from TIFF
    OcrResult result = ocr.Read(input);
    result.SaveAsSearchablePdf("searchable.pdf");
}
ImportsIronOcrDim ocr As New IronTesseract()Using input As New OcrInput() ' Configure document properties input.Title = "Scanned Archive Document" ' Select pages to process Dim pageIndices AsInteger() = {1, 2} input.LoadImageFrames("example.tiff", pageIndices) ' Create searchable PDF from TIFF Dim result AsOcrResult = ocr.Read(input) result.SaveAsSearchablePdf("searchable.pdf")EndUsing
Imports IronOcr

Dim ocr As New IronTesseract()

Using input As New OcrInput()
    ' Configure document properties
    input.Title = "Scanned Archive Document"

    ' Select pages to process
    Dim pageIndices As Integer() = {1, 2}
    input.LoadImageFrames("example.tiff", pageIndices)

    ' Create searchable PDF from TIFF
    Dim result As OcrResult = ocr.Read(input)
    result.SaveAsSearchablePdf("searchable.pdf")
End Using
Jak wyeksportować wyniki OCR jako HOCR HTML?
IronOCR obsługuje eksport HOCR HTML, umożliwiając konwersję plików PDF o strukturze do formatu HTML oraz plików TIFF do formatu HTML przy zachowaniu informacji o układzie:
using IronOcr;var ocr = new IronTesseract();using (var input = new OcrInput()){ // Set HTML title input.Title = "Document Archive"; // Process multiple document types input.LoadImage("image2.jpeg"); input.LoadPdf("example.pdf", "password"); // Add TIFF pages var pageIndices = new int[] { 1, 2 }; input.LoadImageFrames("example.tiff", pageIndices); // Export as HOCR with position data OcrResult result = ocr.Read(input); result.SaveAsHocrFile("hocr.html");}
using IronOcr;

var ocr = new IronTesseract();

using (var input = new OcrInput())
{
    // Set HTML title
    input.Title = "Document Archive";

    // Process multiple document types
    input.LoadImage("image2.jpeg");
    input.LoadPdf("example.pdf", "password");

    // Add TIFF pages
    var pageIndices = new int[] { 1, 2 };
    input.LoadImageFrames("example.tiff", pageIndices);

    // Export as HOCR with position data
    OcrResult result = ocr.Read(input);
    result.SaveAsHocrFile("hocr.html");
}
ImportsIronOcrDim ocr As New IronTesseract()Using input As New OcrInput() ' Set HTML title input.Title = "Document Archive" ' Process multiple document types input.LoadImage("image2.jpeg") input.LoadPdf("example.pdf", "password") ' Add TIFF pages Dim pageIndices AsInteger() = {1, 2} input.LoadImageFrames("example.tiff", pageIndices) ' Export as HOCR with position data Dim result AsOcrResult = ocr.Read(input) result.SaveAsHocrFile("hocr.html")EndUsing
Imports IronOcr

Dim ocr As New IronTesseract()

Using input As New OcrInput()
    ' Set HTML title
    input.Title = "Document Archive"

    ' Process multiple document types
    input.LoadImage("image2.jpeg")
    input.LoadPdf("example.pdf", "password")

    ' Add TIFF pages
    Dim pageIndices As Integer() = {1, 2}
    input.LoadImageFrames("example.tiff", pageIndices)

    ' Export as HOCR with position data
    Dim result As OcrResult = ocr.Read(input)
    result.SaveAsHocrFile("hocr.html")
End Using
Czy IronOCR może odczytywać BarCodes wraz z tekstem?
IronOCR w unikalny sposób łączy rozpoznawanie tekstu z możliwością odczytu kodów kreskowych, eliminując potrzebę stosowania oddzielnych bibliotek:
// Enable combined text and barcode recognitionusing IronOcr;var ocr = new IronTesseract();// Enable barcode detectionocr.Configuration.ReadBarCodes = true;using (var input = new OcrInput()){ // Load image containing both text and barcodes input.LoadImage("img/Barcode.png"); // Process both text and barcodes var result = ocr.Read(input); // Extract barcode data foreach (var barcode in result.Barcodes) {Console.WriteLine($"Barcode Value: {barcode.Value}");Console.WriteLine($"Format: {barcode.Format}"); }}
// Enable combined text and barcode recognition
using IronOcr;

var ocr = new IronTesseract();

// Enable barcode detection
ocr.Configuration.ReadBarCodes = true;

using (var input = new OcrInput())
{
    // Load image containing both text and barcodes
    input.LoadImage("img/Barcode.png");

    // Process both text and barcodes
    var result = ocr.Read(input);

    // Extract barcode data
    foreach (var barcode in result.Barcodes)
    {
        Console.WriteLine($"Barcode Value: {barcode.Value}");
        Console.WriteLine($"Format: {barcode.Format}");
    }
}
C#
Jak uzyskać dostęp do szczegółowych wyników OCR i metadanych?
Obiekt wyników IronOCR dostarcza kompleksowych danych, które zaawansowani programiści mogą wykorzystać w zaawansowanych aplikacjach.
Każdy OcrResult zawiera hierarchiczne kolekcje: strony, akapity, linie, słowa i znaki. Wszystkie elementy zawierają szczegółowe metadane, takie jak lokalizacja, informacje o czcionkach i wskaźniki pewności.
Poszczególne elementy (akapity, słowa, BarCodes) można eksportować jako obrazy lub mapy bitowe w celu dalszego przetwarzania:
using System;using IronOcr;using IronSoftware.Drawing;// Configure with barcode supportIronTesseract ocr = new IronTesseract{Configuration = { ReadBarCodes = true }};using OcrInput input = new OcrInput();// Process multi-page documentint[] pageIndices = { 1, 2 };input.LoadImageFrames(@"img\Potter.tiff", pageIndices);OcrResult result = ocr.Read(input);// Navigate the complete results hierarchyforeach (var page in result.Pages){ // Page-level data int pageNumber = page.PageNumber; string pageText = page.Text; int pageWordCount = page.WordCount; // Extract page elements OcrResult.Barcode[] barcodes = page.Barcodes; AnyBitmap pageImage = page.ToBitmap(); double pageWidth = page.Width; double pageHeight = page.Height; foreach (var paragraph in page.Paragraphs) { // Paragraph properties int paragraphNumber = paragraph.ParagraphNumber; string paragraphText = paragraph.Text; double paragraphConfidence = paragraph.Confidence; var textDirection = paragraph.TextDirection; foreach (var line in paragraph.Lines) { // Line details including baseline information string lineText = line.Text; double lineConfidence = line.Confidence; double baselineAngle = line.BaselineAngle; double baselineOffset = line.BaselineOffset; foreach (var word in line.Words) { // Word-level data string wordText = word.Text; double wordConfidence = word.Confidence; // Font information (when available) if (word.Font != null) { string fontName = word.Font.FontName; double fontSize = word.Font.FontSize; bool isBold = word.Font.IsBold; bool isItalic = word.Font.IsItalic; } foreach (var character in word.Characters) { // Character-level analysis string charText = character.Text; double charConfidence = character.Confidence; // Alternative character choices for spell-checking OcrResult.Choice[] alternatives = character.Choices; } } } }}
using System;
using IronOcr;
using IronSoftware.Drawing;

// Configure with barcode support
IronTesseract ocr = new IronTesseract
{
    Configuration = { ReadBarCodes = true }
};

using OcrInput input = new OcrInput();

// Process multi-page document
int[] pageIndices = { 1, 2 };
input.LoadImageFrames(@"img\Potter.tiff", pageIndices);

OcrResult result = ocr.Read(input);

// Navigate the complete results hierarchy
foreach (var page in result.Pages)
{
    // Page-level data
    int pageNumber = page.PageNumber;
    string pageText = page.Text;
    int pageWordCount = page.WordCount;

    // Extract page elements
    OcrResult.Barcode[] barcodes = page.Barcodes;
    AnyBitmap pageImage = page.ToBitmap();
    double pageWidth = page.Width;
    double pageHeight = page.Height;

    foreach (var paragraph in page.Paragraphs)
    {
        // Paragraph properties
        int paragraphNumber = paragraph.ParagraphNumber;
        string paragraphText = paragraph.Text;
        double paragraphConfidence = paragraph.Confidence;
        var textDirection = paragraph.TextDirection;

        foreach (var line in paragraph.Lines)
        {
            // Line details including baseline information
            string lineText = line.Text;
            double lineConfidence = line.Confidence;
            double baselineAngle = line.BaselineAngle;
            double baselineOffset = line.BaselineOffset;

            foreach (var word in line.Words)
            {
                // Word-level data
                string wordText = word.Text;
                double wordConfidence = word.Confidence;

                // Font information (when available)
                if (word.Font != null)
                {
                    string fontName = word.Font.FontName;
                    double fontSize = word.Font.FontSize;
                    bool isBold = word.Font.IsBold;
                    bool isItalic = word.Font.IsItalic;
                }

                foreach (var character in word.Characters)
                {
                    // Character-level analysis
                    string charText = character.Text;
                    double charConfidence = character.Confidence;

                    // Alternative character choices for spell-checking
                    OcrResult.Choice[] alternatives = character.Choices;
                }
            }
        }
    }
}
ImportsSystemImportsIronOcrImportsIronSoftware.Drawing' Configure with barcode supportDim ocr As New IronTesseractWith { .Configuration = New TesseractConfigurationWith { .ReadBarCodes = True }}Using input As New OcrInput() ' Process multi-page document Dim pageIndices AsInteger() = {1, 2} input.LoadImageFrames("img\Potter.tiff", pageIndices) Dim result AsOcrResult = ocr.Read(input) ' Navigate the complete results hierarchy For Each page In result.Pages ' Page-level data Dim pageNumber AsInteger = page.PageNumber Dim pageText AsString = page.Text Dim pageWordCount AsInteger = page.WordCount ' Extract page elements Dim barcodes AsOcrResult.Barcode() = page.Barcodes Dim pageImage AsAnyBitmap = page.ToBitmap() Dim pageWidth AsDouble = page.Width Dim pageHeight AsDouble = page.Height For Each paragraph In page.Paragraphs ' Paragraph properties Dim paragraphNumber AsInteger = paragraph.ParagraphNumber Dim paragraphText AsString = paragraph.Text Dim paragraphConfidence AsDouble = paragraph.Confidence Dim textDirection = paragraph.TextDirection For Each line In paragraph.Lines ' Line details including baseline information Dim lineText AsString = line.Text Dim lineConfidence AsDouble = line.Confidence Dim baselineAngle AsDouble = line.BaselineAngle Dim baselineOffset AsDouble = line.BaselineOffset For Each word In line.Words ' Word-level data Dim wordText AsString = word.Text Dim wordConfidence AsDouble = word.Confidence ' Font information (when available) If word.FontIsNot Nothing Then Dim fontName AsString = word.Font.FontName Dim fontSize AsDouble = word.Font.FontSize Dim isBold AsBoolean = word.Font.IsBold Dim isItalic AsBoolean = word.Font.IsItalic End If For Each character In word.Characters ' Character-level analysis Dim charText AsString = character.Text Dim charConfidence AsDouble = character.Confidence ' Alternative character choices for spell-checking Dim alternatives AsOcrResult.Choice() = character.Choices Next Next Next Next NextEndUsing
Imports System
Imports IronOcr
Imports IronSoftware.Drawing

' Configure with barcode support
Dim ocr As New IronTesseract With {
    .Configuration = New TesseractConfiguration With {
        .ReadBarCodes = True
    }
}

Using input As New OcrInput()

    ' Process multi-page document
    Dim pageIndices As Integer() = {1, 2}
    input.LoadImageFrames("img\Potter.tiff", pageIndices)

    Dim result As OcrResult = ocr.Read(input)

    ' Navigate the complete results hierarchy
    For Each page In result.Pages
        ' Page-level data
        Dim pageNumber As Integer = page.PageNumber
        Dim pageText As String = page.Text
        Dim pageWordCount As Integer = page.WordCount

        ' Extract page elements
        Dim barcodes As OcrResult.Barcode() = page.Barcodes
        Dim pageImage As AnyBitmap = page.ToBitmap()
        Dim pageWidth As Double = page.Width
        Dim pageHeight As Double = page.Height

        For Each paragraph In page.Paragraphs
            ' Paragraph properties
            Dim paragraphNumber As Integer = paragraph.ParagraphNumber
            Dim paragraphText As String = paragraph.Text
            Dim paragraphConfidence As Double = paragraph.Confidence
            Dim textDirection = paragraph.TextDirection

            For Each line In paragraph.Lines
                ' Line details including baseline information
                Dim lineText As String = line.Text
                Dim lineConfidence As Double = line.Confidence
                Dim baselineAngle As Double = line.BaselineAngle
                Dim baselineOffset As Double = line.BaselineOffset

                For Each word In line.Words
                    ' Word-level data
                    Dim wordText As String = word.Text
                    Dim wordConfidence As Double = word.Confidence

                    ' Font information (when available)
                    If word.Font IsNot Nothing Then
                        Dim fontName As String = word.Font.FontName
                        Dim fontSize As Double = word.Font.FontSize
                        Dim isBold As Boolean = word.Font.IsBold
                        Dim isItalic As Boolean = word.Font.IsItalic
                    End If

                    For Each character In word.Characters
                        ' Character-level analysis
                        Dim charText As String = character.Text
                        Dim charConfidence As Double = character.Confidence

                        ' Alternative character choices for spell-checking
                        Dim alternatives As OcrResult.Choice() = character.Choices
                    Next
                Next
            Next
        Next
    Next
End Using
Podsumowanie
IronOCR zapewnia programistom C# najbardziej zaawansowaną implementację API Tesseract, działającą płynnie na platformach Windows, Linux i Mac. Możliwość dokładnego odczytu tekstu z obrazu za pomocą IronOCR - nawet z dokumentów o niskiej jakości - wyróżnia to rozwiązanie spośród podstawowych rozwiązań OCR.
Unikalne funkcje biblioteki obejmują zintegrowane odczytywanie kodów BarCode oraz możliwość eksportowania wyników jako pliki PDF z funkcją wyszukiwania lub HOCR HTML, co nie jest dostępne w standardowych implementacjach Tesseract.
Jak mogę przekonwertować obrazy na tekst w języku C# bez użycia Tesseract?
Możesz użyć IronOCR do konwersji obrazów na tekst w języku C# bez konieczności korzystania z Tesseract. IronOCR upraszcza ten proces dzięki wbudowanym metodom, które bezpośrednio obsługują konwersję obrazu na tekst.
Jak poprawić dokładność OCR w przypadku obrazów o niskiej jakości?
IronOCR udostępnia filtry obrazu, takie jak Input.Deskew() i Input.DeNoise(), które można wykorzystać do poprawy jakości obrazów o niskiej rozdzielczości poprzez korekcję przekrzywienia i redukcję szumów, co znacznie poprawia dokładność OCR.
Jakie kroki należy wykonać, aby wyodrębnić tekst z wielostronicowego dokumentu przy użyciu OCR w języku C#?
Aby wyodrębnić tekst z dokumentów wielostronicowych, IronOCR umożliwia ładowanie i przetwarzanie każdej strony przy użyciu metod takich jak LoadPdf() dla plików PDF lub obsługi plików TIFF, skutecznie konwertując każdą stronę na tekst.
Czy możliwe jest jednoczesne odczytywanie BARCODE-ów i tekstu z obrazu?
Tak, IronOCR może odczytywać zarówno tekst, jak i BarCodes z jednego obrazu. Odczyt BarCodes można włączyć za pomocą OCR.Configuration.ReadBarCodes = true, co pozwala na wyodrębnianie zarówno danych tekstowych, jak i danych z BarCodes.
Jak skonfigurować OCR do przetwarzania dokumentów w wielu językach?
IronOCR obsługuje ponad 125 języków i pozwala ustawić język podstawowy za pomocą OCR.Language oraz dodać dodatkowe języki za pomocą OCR.AddSecondaryLanguage() w celu przetwarzania dokumentów wielojęzycznych.
Jakie metody są dostępne do eksportowania wyników OCR w różnych formatach?
IronOCR oferuje kilka metod eksportowania wyników OCR, takich jak SaveAsSearchablePdf() dla plików PDF, SaveAsTextFile() dla zwykłego tekstu oraz SaveAsHocrFile() dla formatu HOCR HTML.
Jak mogę zoptymalizować szybkość przetwarzania OCR w przypadku dużych plików graficznych?
Aby zoptymalizować szybkość przetwarzania OCR, należy użyć funkcji OcrLanguage.EnglishFast biblioteki IronOCR w celu szybszego rozpoznawania języka oraz zdefiniować konkretne obszary do OCR za pomocą System.Drawing.Rectangle, aby skrócić czas przetwarzania.
Jak poradzić sobie z przetwarzaniem OCR w przypadku chronionych plików PDF?
W przypadku plików PDF z zabezpieczeniami należy użyć metody LoadPdf() wraz z prawidłowym hasłem. IronOCR obsługuje pliki PDF oparte na obrazach, automatycznie konwertując strony na obrazy w celu przetworzenia przez OCR.
Co należy zrobić, jeśli wyniki OCR są niedokładne?
Jeśli wyniki OCR są niedokładne, rozważ użycie funkcji poprawy jakości obrazu IronOCR, takich jak Input.Deskew() i Input.DeNoise(), oraz upewnij się, że zainstalowane są odpowiednie pakiety językowe.
Czy mogę dostosować proces OCR, aby wykluczyć określone znaki?
Tak, IronOCR umożliwia dostosowanie procesu OCR za pomocą właściwości BlackListCharacters w celu wykluczenia określonych znaków, co poprawia dokładność i szybkość przetwarzania poprzez skupienie się wyłącznie na istotnym tekście.
Jacob Mellor jest Chief Technology Officer w Iron Software i wizjonerskim inżynierem, pionierem technologii C# PDF. Jako pierwotny deweloper głównej bazy kodowej Iron Software, kształtuje architekturę produktów firmy od jej początku, przekształcając ją wspólnie z CEO Cameron Rimington w firmę liczącą ponad 50 osób, obsługującą NASA, Teslę i światowe agencje rządowe.


 Zrzut ekranu demonstrujący zdolność IronOCR do wyodrębniania tekstu z obrazu PNG z perfekcyjną dokładnością
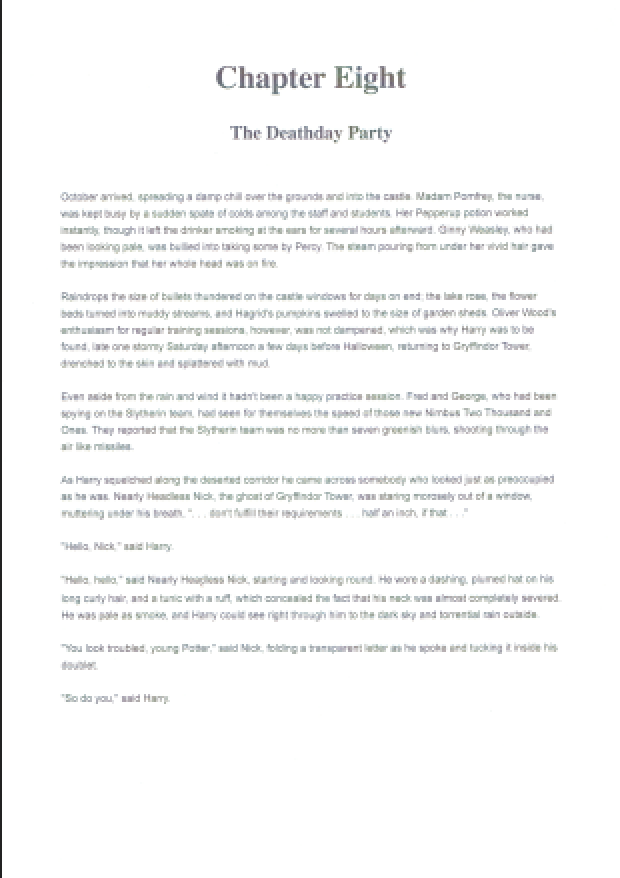
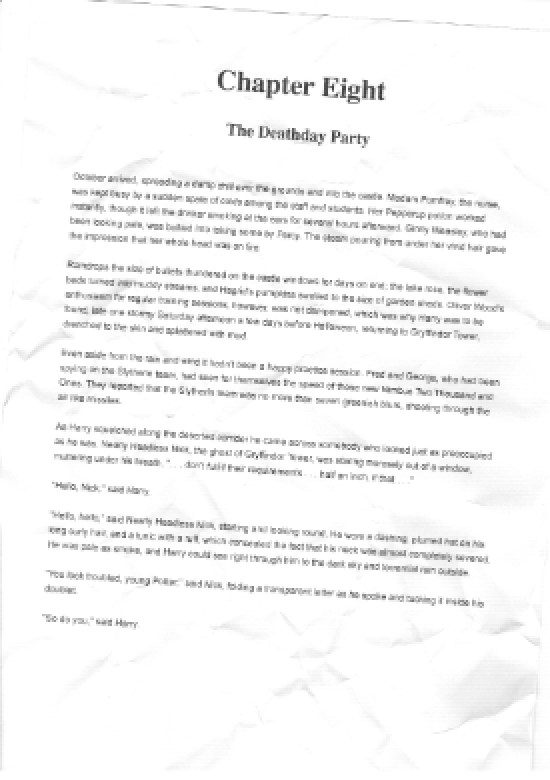
 Dokument pokazujący precyzyjne wyodrębnianie tekstu na podstawie regionu przy użyciu zaznaczenia prostokątnego w IronOCR