

C#網路爬蟲程式庫
超越基本的HTML解析。在.NET 10上進行自動化的網頁爬取,並結合多執行緒,以大規模地提取和匯出結構化資料。
- 使用 CSS選擇器、XPath和JavaScript渲染進行爬取
- 多執行緒處理數百個同時請求
- 支援 限速、代理伺服器、使用者代理和robots.txt
- 免費30天試用,功能完整,無需信用卡
C# Web Scraper
using IronWebScraper;

public class Program
{
    private static void Main(string[] args)
    {
        var ScrapeJob = new BlogScraper();
        ScrapeJob.Start();
    }
}

public class BlogScraper : WebScraper
{
    public override void Init()
    {
        LoggingLevel = LogLevel.All;
        Request("https://www.zyte.com/blog/", Parse);
    }

    public override void Parse(Response response)
    {
        foreach (HtmlNode title_link in response.Css(".oxy-post-title"))
        {
            string strTitle = title_link.TextContentClean;
            Scrape(new ScrapedData() { { "Title", strTitle } });
        }

        if (response.CssExists("div.oxy-easy-posts-pages > a[href]"))
        {
            string next_page = response.Css("div.oxy-easy-posts-pages > a[href]")[0].Attributes["href"];
            Request(next_page, Parse);
        }
    }
}
Imports IronWebScraper
Public Class Program
Private Shared Sub Main(args As String())
Dim ScrapeJob = New BlogScraper()
ScrapeJob.Start()
End Sub
End Class
Public Class BlogScraper
Inherits WebScraper
Public Overrides Sub Init()
LoggingLevel = LogLevel.All
Request("https://www.zyte.com/blog/", AddressOf Parse)
End Sub
Public Overrides Sub Parse(response As Response)
For Each title_link As HtmlNode In response.Css(".oxy-post-title")
Dim strTitle As String = title_link.TextContentClean
Scrape(New ScrapedData() From {{"Title", strTitle}})
Next
If response.CssExists("div.oxy-easy-posts-pages > a[href]") Then
Dim next_page As String = response.Css("div.oxy-easy-posts-pages > a[href]")(0).Attributes("href")
Request(next_page, AddressOf Parse)
End If
End Sub
End Class
PM >Install-Package IronWebScraper


Works with AI Coding Agents
 Claude
 Codex
 GitHub Copilot
 Cursor
 Antigravity
 Other coding agents
Runs Inside Your Infrastructure
No MCPs or external processing. IronWebScraper runs inside your application, keeping documents in your control.
AI-ready Documentation
Clear documentation, API references, and tutorials help coding agents use IronWebScraper effectively.
Built for Enterprise Workflows
Add enterprise-grade document capabilities where accuracy, consistency, and control matters.
跨平台支援
設計用於C#, F#, & VB.NET運行於.NET 10, 9, 8, 7, 6, 5, Core, Standard或Framework


為什麼選擇IronWebScraper
從單個C#類別中抓取數千頁面。CSS選擇器、XPath、JavaScript渲染、虛擬身份和禮貌控制於一個程式庫中。

 廣泛的爬取能力
- 使用CSS選擇器或XPath表達式進行解析;jQuery風格的語法。
- 渲染JavaScript頁面,而不僅僅是靜態HTML。
- 輸出到C#類別實例、JSON或下載的檔案。
 5分鐘內即可上手
- → 5分鐘快速入門。
- 簡單API:
Request(url, Parse),response.Css(".selector"),Scrape(data). - 智能預設:多執行緒、禮貌性和快取由框架處理。
 企業效能
- .NET 10、Core、Standard或Framework
- C#、VB.NET、F# 支援。DigiCert 簽署的二進位檔。
- 部署於任何地方:Windows、Linux、macOS、Docker、Azure、AWS。

 禮貌,韌性強,易於審計
- 內建限速、代理支援、使用者代理和robots.txt遵從。
- 虛擬使用者身份:每次請求的使用者代理、Cookie、登入和IP。
- 自動儲存工作在例外情況、崩潰或停電後恢復。
 開發者優先支援與授權
- 永久授權一次購買,永久使用。可選更新和續費。
- 24/5 工程師支援(Premium中的24/7)。真實的人類,聊天中位回應時間少於1分鐘。
- 30天退款保證不合適?全額退款,無需詢問。
 建築商
- 您實際會使用的功能:
- CSS選擇器 & XPath
- multithreaded crawling
- 代理與使用者端輪換
- 虛擬使用者身份
- auto-resume on crash
- JavaScript呈現
- 限制和禮貌
- robots.txt合規
- action replay (offline)
- JSON 或類別輸出
- 無所不在:Windows、Linux、macOS、Docker、Azure、AWS。
 對於買家
- 受到Iron Suite數百萬工程師的信賴。
- 為真實工作負載而設計:系統遷移、競爭分析、搜尋索引、資料挖掘。
- 採購友好:永久授權、可選續約、可提供發票、多種付款選項(包括本地選項:Amazon Pay、支付寶、Apple Pay、IDEAL、SEPA、ACH)。
- 30天退款保證。
獲得全球數百萬工程師的信賴


開始使用:C# 程式碼範例
 C# Web Scraper
using IronWebScraper;

public class Program
{
    private static void Main(string[] args)
    {
        var ScrapeJob = new BlogScraper();
        ScrapeJob.Start();
    }
}

public class BlogScraper : WebScraper
{
    public override void Init()
    {
        LoggingLevel = LogLevel.All;
        Request("https://www.zyte.com/blog/", Parse);
    }

    public override void Parse(Response response)
    {
        foreach (HtmlNode title_link in response.Css(".oxy-post-title"))
        {
            string strTitle = title_link.TextContentClean;
            Scrape(new ScrapedData() { { "Title", strTitle } });
        }

        if (response.CssExists("div.oxy-easy-posts-pages > a[href]"))
        {
            string next_page = response.Css("div.oxy-easy-posts-pages > a[href]")[0].Attributes["href"];
            Request(next_page, Parse);
        }
    }
}
Imports IronWebScraper

Public Class Program
    Private Shared Sub Main(args As String())
        Dim ScrapeJob = New BlogScraper()
        ScrapeJob.Start()
    End Sub
End Class

Public Class BlogScraper
    Inherits WebScraper

    Public Overrides Sub Init()
        LoggingLevel = LogLevel.All
        Request("https://www.zyte.com/blog/", AddressOf Parse)
    End Sub

    Public Overrides Sub Parse(response As Response)
        For Each title_link As HtmlNode In response.Css(".oxy-post-title")
            Dim strTitle As String = title_link.TextContentClean
            Scrape(New ScrapedData() From {{"Title", strTitle}})
        Next

        If response.CssExists("div.oxy-easy-posts-pages > a[href]") Then
            Dim next_page As String = response.Css("div.oxy-easy-posts-pages > a[href]")(0).Attributes("href")
            Request(next_page, AddressOf Parse)
        End If
    End Sub
End Class
PM > Install-Package IronWebScraper
直接從我們的開發團隊獲得人工支援
無論是產品、整合還是授權的問題,Iron產品開發團隊隨時在此支持您的所有問題。請與Iron聯繫並開啟對話,以充分利用我們的程式庫於您的專案中。
強大的爬取引擎由您掌控
只需編寫一個C#網頁抓取類別,即可將數千甚至數百萬個網頁抓取為C#類別實例、JSON或下載的文件。IronWebScraper允許您編寫簡潔的線性工作流程,模擬人類的瀏覽行為。IronWebScraper將您的程式作為一群虛擬網頁瀏覽器運行,並且在大規模並行的同時,保持禮貌並具備容錯能力。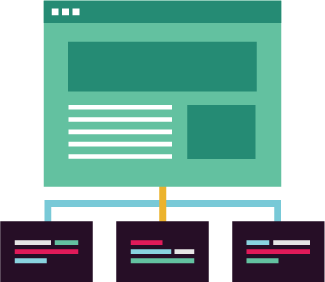
簡單、靈活的邏輯
IronWebScraper必須被程式化以瞭解如何處理所遇到的每個「型別」頁面。這可以透過CSS選擇器或XPath表達式以非常簡潔的方式達成,並可以在C#中完全自訂。這種自由度讓您可以決定要抓取網站中的哪些頁面,以及如何處理提取的資料。每個方法都可以在Visual Studio中整齊地進行除錯和觀察。
快速和禮貌的行為
IronWebScraper 處理多執行緒和網路請求,使開發者無需管理便能夠啟用數百個併發執行緒。可以設置禮貌來限制請求的頻率,從而降低目標網頁伺服器過載的風險。
建立虛擬使用者身份
IronWebScraper可以使用一個或多個「身份」 - 模擬現實世界人類請求的會話。每次請求可以程式化或隨機分配其自己的身份、使用者代理、Cookie、登入資訊,甚至IP地址。請求設置為自動唯一,結合URL、解析方法和post變數。
動作重播
IronWebScraper使用先進的快取技術,讓開發者可以即時修改程式碼並重播每個先前的請求而無需連接網際網路。每個擷取任務會自動儲存,並可在發生異常或停電影響時恢復。
使用Microsoft Visual Studio快速安裝
IronWebScraper透過Visual Studio安裝程式,讓您快速擁有Web Scraping工具。無論是在Visual Studio內直接從NuGet安裝,或是下載DLL,您都能迅速設定完成。僅需一個DLL且無需依賴其他元件。支持:
.NET 網路爬蟲社群教程
VBC#ASP.NET
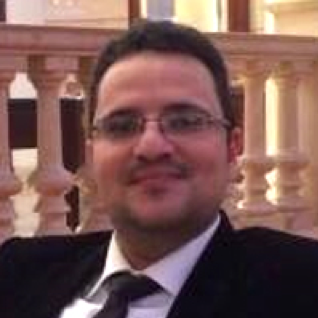
C#和VB.NET專案中的網頁爬蟲
查看Ahmed如何在其專案中使用IronWebScraper將內容從一個網站遷移到另一個網站。提供用於抓取電子商務和部落格網站的範例專案和程式碼。
我們的客戶使用IronWebScraper與...
會計與財務系統
- # 收據
- # 報告
- # 發票列印

業務數位化
- # 文件
- # 排序與標籤
- # 紙張替換
企業內容管理
- # 內容製作
- # 文件管理
- # 內容分發
資料與報告應用程式
- # 性能追蹤
- # 趨勢映射
- # 報告


數以千計的企業、政府、中小型企業和開發者都信賴Iron Software產品。
Iron團隊在.NET軟體元件市場擁有超過10年的經驗。



準備好開始了嗎?
Nuget Downloads 146,366|版本:2026.9剛剛發布

IronWebScraper 是 IRONSUITE 的一部分
10 款適用於辦公室文件的 .NET API 產品


您需要的強大功能來抓取並輸出乾淨的、結構化的資料。

