

C#网页抓取库
突破基础HTML解析的局限。借助.NET 10的多线程技术,实现自动化网页抓取,大规模提取并导出结构化数据。
- Scrape 使用 CSS 选择器、XPath 和 JavaScript 渲染
- 具有数百个同时请求的多线程
- 支持节流、代理、用户代理和 robots.txt
- 免费试用 30 天,功能齐全,无需信用卡
C# 网页抓取器
using IronWebScraper;

public class Program
{
    private static void Main(string[] args)
    {
        var ScrapeJob = new BlogScraper();
        ScrapeJob.Start();
    }
}

public class BlogScraper : WebScraper
{
    public override void Init()
    {
        LoggingLevel = LogLevel.All;
        Request("https://www.zyte.com/blog/", Parse);
    }

    public override void Parse(Response response)
    {
        foreach (HtmlNode title_link in response.Css(".oxy-post-title"))
        {
            string strTitle = title_link.TextContentClean;
            Scrape(new ScrapedData() { { "Title", strTitle } });
        }

        if (response.CssExists("div.oxy-easy-posts-pages > a[href]"))
        {
            string next_page = response.Css("div.oxy-easy-posts-pages > a[href]")[0].Attributes["href"];
            Request(next_page, Parse);
        }
    }
}
Imports IronWebScraper
Public Class Program
Private Shared Sub Main(args As String())
Dim ScrapeJob = New BlogScraper()
ScrapeJob.Start()
End Sub
End Class
Public Class BlogScraper
Inherits WebScraper
Public Overrides Sub Init()
LoggingLevel = LogLevel.All
Request("https://www.zyte.com/blog/", AddressOf Parse)
End Sub
Public Overrides Sub Parse(response As Response)
For Each title_link As HtmlNode In response.Css(".oxy-post-title")
Dim strTitle As String = title_link.TextContentClean
Scrape(New ScrapedData() From {{"Title", strTitle}})
Next
If response.CssExists("div.oxy-easy-posts-pages > a[href]") Then
Dim next_page As String = response.Css("div.oxy-easy-posts-pages > a[href]")(0).Attributes("href")
Request(next_page, AddressOf Parse)
End If
End Sub
End Class
PM >Install-Package IronWebScraper


Works with AI Coding Agents
 Claude
 Codex
 GitHub Copilot
 Cursor
 Antigravity
 Other coding agents
Runs Inside Your Infrastructure
No MCPs or external processing. IronWebScraper runs inside your application, keeping documents in your control.
AI-ready Documentation
Clear documentation, API references, and tutorials help coding agents use IronWebScraper effectively.
Built for Enterprise Workflows
Add enterprise-grade document capabilities where accuracy, consistency, and control matters.
跨平台支持
为在.NET 10, 9, 8, 7, 6, 5, Core, Standard, or Framework上运行的C#, F#, & VB.NET而设计


为什么选择 IronWebScraper
从单个 C# 类中抓取成千上万的页面。CSS 选择器、XPath、JavaScript 渲染、虚拟身份和礼貌控件在一个库中。

 广泛的抓取能力
- using CSS 选择器或 XPath 表达式进行解析;jQuery 风格的语法。
- 渲染 JavaScript 页面,不仅是静态 HTML。
- 输出到 C# 类实例、JSON 或下载文件。
 5 分钟内启动
- → 5分钟快速入门。
- 简单API:
Request(url, Parse),response.Css(".selector"),Scrape(data). - 智能默认设置:由框架处理多线程、礼貌性和缓存。
 Enterprise绩效
- .NET 10,Core,Standard,或 Framework
- 支持C#,VB.NET,F#。DigiCert签署的二进制文件。
- 部署于任何地方:Windows、Linux、macOS、Docker、Azure、AWS。

 礼貌、弹性和审核友好
- 内置的限流、代理支持、用户代理和 robots.txt 合规性。
- 虚拟用户身份:每次请求的用户代理、cookies、登录和 IP。
- 自动保存的作业在出现异常、崩溃或掉电后恢复。
 以开发者为先的支持和许可
- 永久许可:一次购买,永久使用。可选更新和续订。
- 24/5 工程师支持(Premium中24/7)。真人,聊天响应中位数<1分钟。
- 30天退款保证不合适?全额退款,无需解释。
 为建筑者
- 您将真正使用的功能:
- CSS 选择器 & XPath
- multithreaded crawling
- 代理 & 用户代理轮换
- 虚拟用户身份
- auto-resume on crash
- JavaScript渲染
- 限流 & 礼貌性
- robots.txt 合规
- 动作重放(离线)
- JSON 或类输出
- 适用于任何地方:Windows、Linux、macOS、Docker、Azure、AWS。
 购买者
- 被Iron Suite的数百万工程师信赖。
- 为真实工作负载构建:系统迁移、竞争分析、搜索索引、数据挖掘。
- 采购友好:永久许可证,可选续订,可开发票,多种支付选项(包括本地:Amazon Pay,支付宝,Apple Pay,IDEAL,SEPA,ACH)。
- 30 天退款保证。
深受全球 数百万工程师的信赖


入门:C#代码示例
 C# 网页抓取器
using IronWebScraper;

public class Program
{
    private static void Main(string[] args)
    {
        var ScrapeJob = new BlogScraper();
        ScrapeJob.Start();
    }
}

public class BlogScraper : WebScraper
{
    public override void Init()
    {
        LoggingLevel = LogLevel.All;
        Request("https://www.zyte.com/blog/", Parse);
    }

    public override void Parse(Response response)
    {
        foreach (HtmlNode title_link in response.Css(".oxy-post-title"))
        {
            string strTitle = title_link.TextContentClean;
            Scrape(new ScrapedData() { { "Title", strTitle } });
        }

        if (response.CssExists("div.oxy-easy-posts-pages > a[href]"))
        {
            string next_page = response.Css("div.oxy-easy-posts-pages > a[href]")[0].Attributes["href"];
            Request(next_page, Parse);
        }
    }
}
Imports IronWebScraper

Public Class Program
    Private Shared Sub Main(args As String())
        Dim ScrapeJob = New BlogScraper()
        ScrapeJob.Start()
    End Sub
End Class

Public Class BlogScraper
    Inherits WebScraper

    Public Overrides Sub Init()
        LoggingLevel = LogLevel.All
        Request("https://www.zyte.com/blog/", AddressOf Parse)
    End Sub

    Public Overrides Sub Parse(response As Response)
        For Each title_link As HtmlNode In response.Css(".oxy-post-title")
            Dim strTitle As String = title_link.TextContentClean
            Scrape(New ScrapedData() From {{"Title", strTitle}})
        Next

        If response.CssExists("div.oxy-easy-posts-pages > a[href]") Then
            Dim next_page As String = response.Css("div.oxy-easy-posts-pages > a[href]")(0).Attributes("href")
            Request(next_page, AddressOf Parse)
        End If
    End Sub
End Class
PM > Install-Package IronWebScraper
直接来自我们开发团队的人工支持
无论是产品、集成还是授权问题,Iron 产品开发团队随时准备回答您所有问题。立即联系并与 Iron 开始对话,以便在您的项目中充分利用我们的库。
强大的抓取引擎掌控在您手中
只需编写一个C#网页抓取器类即可将成千上万甚至百万网页抓取为C#类实例、JSON或下载文件。IronWebScraper允许您编写简洁、线性的工作流程,模拟人类浏览行为。IronWebScraper将作为一群虚拟网络浏览器并行运行您的代码,既有礼貌又具容错性。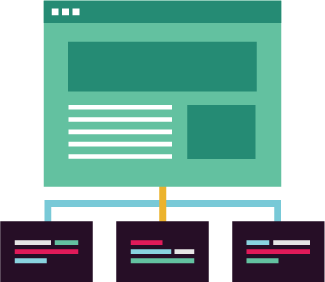
简单、灵活的逻辑
必须编程IronWebScraper以了解如何处理它遇到的每种类型的页面。这是通过使用CSS选择器或XPath表达式以非常简洁的方式实现的,并且可以在C#中完全自定义。这种自由让您可以决定在网站上抓取哪些页面,以及对抓取的数据进行什么操作。每种方法都可以在Visual Studio中干净地调试和观看。
快速而有礼貌的行为
IronWebScraper处理多线程和网络请求,以便同时处理数百个并发线程,而无需开发人员去管理它们。礼貌可以设置为调节请求,从而减少对目标Web服务器的过度负载的风险。
创建虚拟用户身份
IronWebScraper可以使用一个或多个“身份” - 模拟实际世界中人类请求的会话。每个请求可以通过编程方式或随机分配其自己的身份、用户代理、Cookie、登录甚至IP地址。请求通过URL、解析方法和POST变量的组合设置为自动唯一。
动作重放
IronWebScraper使用高级缓存技术,允许开发者在不联机的情况下“现场”更改代码并重放每一个先前的请求。每个抓取作业都会自动保存,并且在出现异常或停电时可以恢复。
通过Microsoft Visual Studio快速安装
IronWebScraper通过Visual Studio安装程序迅速将网页抓取工具掌控在您的手中。无论是在Visual Studio中直接通过NuGet安装还是下载DLL,您都可以迅速完成设置。只需一个DLL,没有依赖项。支持:
.NET网页抓取社区教程
VBC#ASP.NET
C#和VB.NET项目中的网页抓取
了解Ahmed如何在他的项目中使用IronWebScraper将内容从一个站点迁移到另一个站点。提供用于抓取电子商务和博客网站的示例项目和代码
我们的客户使用IronWebScraper...
会计和金融系统
- # 收据
- # 报告
- # 发票打印

业务数字化
- # 文档
- # 订购和标签
- # 纸质替代
企业内容管理
- # 内容制作
- # 文档管理
- # 内容分发
数据和报告应用程序
- # 性能跟踪
- # 趋势映射
- # 报告


数千家企业、政府、中小企业和开发者信赖Iron软件产品。
Iron团队在.NET软件组件市场拥有超过10年的经验。



准备开始了吗?
Nuget Downloads 146,366|版本:2026.9刚刚发布


您所需的抓取和输出清晰、结构化数据的能力。

