Neste tutorial, aprenderemos sobre a extração de legendas embutidas de arquivos de vídeo. Pegaremos um arquivo de vídeo de amostra e extrairemos as legendas incrustadas para um arquivo de texto. Desenvolveremos um programa C# .NET que extrairá as legendas incrustadas usando o processo de OCR. Mantenderei este tutorial simples e fácil para que até mesmo um programador iniciante em C# possa entendê-lo.
Precisamos de um motor de Reconhecimento Óptico de Caracteres (OCR) eficiente que possa processar o vídeo e obter arquivos de legendas independentemente do idioma das legendas.
Existem muitas bibliotecas disponíveis que fornecem resultados de OCR. Algumas delas são pagas, algumas são difíceis de usar, e algumas não são eficientes ou precisas, portanto, é muito difícil encontrar uma biblioteca que seja gratuita, eficiente, fácil de usar e forneça resultados precisos.
IronOCR, que é gratuito para desenvolvimento, oferece um teste gratuito de um mês para fins comerciais. Ele suporta mais de 150 idiomas e fornece melhor precisão do que a maioria das outras bibliotecas OCR disponíveis. Também é eficiente e fácil de usar. Usaremos esta biblioteca para nossa demonstração.
Como fazer OCR de legendas em C#
- Instale a biblioteca C# para realizar OCR em legendas
- Importe a imagem com legenda para uma nova instância
OcrInput - Pré-processe as imagens aplicando filtros selecionados
- Especifique a localização da legenda na imagem para melhorar o desempenho e a precisão do OCR
- Exporte o texto recuperado como arquivo de texto
IronOCR
IronOCR é uma biblioteca desenvolvida e mantida pela Iron Software que ajuda engenheiros de software C# a realizar OCR, leitura de códigos de barras e extração de texto em projetos .NET.
As características do IronOCR incluem:
- Ler texto a partir de muitos formatos, como imagens (JPEG, PNG, BMP), GIF, TIF/TIFF, streams, e PDFs
- Correção de scans e fotos de baixa qualidade com uma variedade de filtros, como Deskew, Denoise, Binarize, Enhance Resolution, Dilate, entre muitos outros
- Leitura de códigos de barras de mais de 20 formatos diferentes, juntamente com suporte a QR Code
- Utilizando a versão mais recente do Tesseract OCR, com seu desempenho otimizado além das outras bibliotecas de seu tipo
- Exportação de PDFs pesquisáveis, Exportação hOCR / HTML, e texto de conteúdo de imagem.
Vamos desenvolver uma aplicação de demonstração para ler números de placas de veículos.
Criar um projeto do Visual Studio
O primeiro passo é criar um novo projeto.
Abra o Visual Studio. Clique em Criar Novo Projeto e selecione o modelo de projeto de Aplicação de Console.
Clique no botão Próximo e nomeie o projeto (eu o nomeei de "OCR Subtitles", você pode nomeá-lo conforme sua escolha).
Clique no botão Próximo e selecione seu Framework alvo. Finalmente, clique no botão Criar para criar o projeto.
O projeto será criado conforme mostrado abaixo.
 Criando um novo projeto no Visual Studio
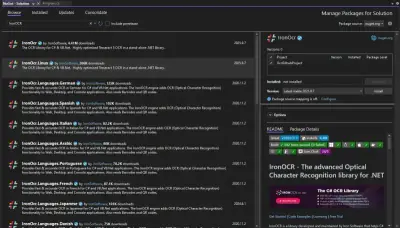
Agora, precisamos instalar a biblioteca IronOCR para usá-la em nosso projeto. A maneira mais fácil é instalá-la através do Gerenciador de Pacotes NuGet para Solução.
Instalar o pacote NuGet do IronOCR
Clique em Ferramentas no menu superior e selecione Gerenciador de Pacotes NuGet > Gerenciar Pacotes NuGet para Solução, como mostrado abaixo.
 Instalando IronOCR dentro do Visual Studio
A seguinte janela será exibida.
 Interface do Gerenciador de Pacotes NuGet do Visual Studio
Clique em procurar e pesquise IronOCR. Selecione o pacote IronOCR e clique no botão Instalar, como mostrado abaixo.
 Procurando por IronOCR na interface do Gerenciador de Pacotes NuGet
A biblioteca IronOCR será instalada e estará pronta para uso.
Vamos escrever um programa para extrair legendas incrustadas.
Vamos usar a seguinte captura de tela para extrair legendas.
 Captura de tela do vídeo de exemplo da qual o texto será extraído
Adicione o seguinte namespace:
using IronOcr;
using IronOcr;
Imports IronOcr
Imports IronOcr
Imports IronOcr
Escreva o código a seguir abaixo da declaração do namespace.
// Initialize IronTesseract object
var ocr = new IronTesseract();
// Create an OCR Input using the specified image path
using (var input = new OcrInput(@"D:\License Plate\plate3.jpg"))
{
    // Perform OCR on the input image to extract text
    var result = ocr.Read(input);
    // Output the extracted text to the console
    Console.WriteLine(result.Text);
}
// Initialize IronTesseract object
var ocr = new IronTesseract();
// Create an OCR Input using the specified image path
using (var input = new OcrInput(@"D:\License Plate\plate3.jpg"))
{
    // Perform OCR on the input image to extract text
    var result = ocr.Read(input);
    // Output the extracted text to the console
    Console.WriteLine(result.Text);
}
// Initialize IronTesseract object
var ocr = new IronTesseract();
// Create an OCR Input using the specified image path
using (var input = new OcrInput(@"D:\License Plate\plate3.jpg"))
{
    // Perform OCR on the input image to extract text
    var result = ocr.Read(input);
    // Output the extracted text to the console
    Console.WriteLine(result.Text);
}
' Initialize IronTesseract object
Dim ocr = New IronTesseract()
' Create an OCR Input using the specified image path
Using input = New OcrInput("D:\License Plate\plate3.jpg")
' Perform OCR on the input image to extract text
Dim result = ocr.Read(input)
' Output the extracted text to the console
Console.WriteLine(result.Text)
End Using
' Initialize IronTesseract object
Dim ocr = New IronTesseract()
' Create an OCR Input using the specified image path
Using input = New OcrInput("D:\License Plate\plate3.jpg")
	' Perform OCR on the input image to extract text
	Dim result = ocr.Read(input)
	' Output the extracted text to the console
	Console.WriteLine(result.Text)
End Using
' Initialize IronTesseract object
Dim ocr = New IronTesseract()
' Create an OCR Input using the specified image path
Using input = New OcrInput("D:\License Plate\plate3.jpg")
	' Perform OCR on the input image to extract text
	Dim result = ocr.Read(input)
	' Output the extracted text to the console
	Console.WriteLine(result.Text)
End Using
O código acima funciona da seguinte forma:
- Initialize
IronTesseract object. Ele irá criar uma instância padrão de IronTesseract.
- Crie um novo objeto
OcrInput populado com um arquivo de imagem de entrada ou documento PDF. OcrInput é o tipo de entrada preferido porque permite OCR de documentos com várias páginas e permite que as imagens sejam aprimoradas antes do OCR para obter resultados mais rápidos e precisos.
- Leia um texto de um Objeto de Entrada OCR e retorne um objeto de Resultado OCR.
ocr.Read irá extrair as legendas da captura de tela de entrada fornecida.
result.Text irá retornar todo o conteúdo extraído da entrada fornecida.
O programa de exemplo produz a seguinte saída no console:
 Saída do console gerada a partir da extração de texto na imagem de exemplo usando IronOCR
Vamos supor que você tenha um quadro de vídeo que contém tanto o título do vídeo quanto as legendas:
 Um único quadro de um vídeo mais longo contendo regiões de texto para o título e as legendas do vídeo
Nosso objetivo é extrair as legendas embutidas na região inferior da imagem. Nesse caso, precisamos especificar a região de texto onde a legenda é exibida.
Especificar Localização da Legenda no Quadro
Podemos usar um System.Drawing.Rectangle para especificar uma região na qual leremos uma legenda do quadro do vídeo. A unidade de medida é sempre pixels.
Usaremos o seguinte código de exemplo para especificar a região de texto.
// Initialize IronTesseract object
var ocr = new IronTesseract();
// Create an OCR Input and specify the region of interest
using (var input = new OcrInput())
{
    // Define the area within the image where subtitles are located for a 41% improvement on speed
    var contentArea = new CropRectangle(x: 189, y: 272, height: 252, width: 77);
    // Add the specific region of the image to the OCR input
    input.AddImage(@"D:\subtitle\image.png", contentArea);
    // Perform OCR on the specified region
    var result = ocr.Read(input);
    // Output the extracted text to the console
    Console.WriteLine(result.Text);
}
// Initialize IronTesseract object
var ocr = new IronTesseract();
// Create an OCR Input and specify the region of interest
using (var input = new OcrInput())
{
    // Define the area within the image where subtitles are located for a 41% improvement on speed
    var contentArea = new CropRectangle(x: 189, y: 272, height: 252, width: 77);
    // Add the specific region of the image to the OCR input
    input.AddImage(@"D:\subtitle\image.png", contentArea);
    // Perform OCR on the specified region
    var result = ocr.Read(input);
    // Output the extracted text to the console
    Console.WriteLine(result.Text);
}
// Initialize IronTesseract object
var ocr = new IronTesseract();
// Create an OCR Input and specify the region of interest
using (var input = new OcrInput())
{
    // Define the area within the image where subtitles are located for a 41% improvement on speed
    var contentArea = new CropRectangle(x: 189, y: 272, height: 252, width: 77);
    // Add the specific region of the image to the OCR input
    input.AddImage(@"D:\subtitle\image.png", contentArea);
    // Perform OCR on the specified region
    var result = ocr.Read(input);
    // Output the extracted text to the console
    Console.WriteLine(result.Text);
}
' Initialize IronTesseract object
Dim ocr = New IronTesseract()
' Create an OCR Input and specify the region of interest
Using input = New OcrInput()
' Define the area within the image where subtitles are located for a 41% improvement on speed
Dim contentArea = New CropRectangle(x:= 189, y:= 272, height:= 252, width:= 77)
' Add the specific region of the image to the OCR input
input.AddImage("D:\subtitle\image.png", contentArea)
' Perform OCR on the specified region
Dim result = ocr.Read(input)
' Output the extracted text to the console
Console.WriteLine(result.Text)
End Using
' Initialize IronTesseract object
Dim ocr = New IronTesseract()
' Create an OCR Input and specify the region of interest
Using input = New OcrInput()
	' Define the area within the image where subtitles are located for a 41% improvement on speed
	Dim contentArea = New CropRectangle(x:= 189, y:= 272, height:= 252, width:= 77)
	' Add the specific region of the image to the OCR input
	input.AddImage("D:\subtitle\image.png", contentArea)
	' Perform OCR on the specified region
	Dim result = ocr.Read(input)
	' Output the extracted text to the console
	Console.WriteLine(result.Text)
End Using
' Initialize IronTesseract object
Dim ocr = New IronTesseract()
' Create an OCR Input and specify the region of interest
Using input = New OcrInput()
	' Define the area within the image where subtitles are located for a 41% improvement on speed
	Dim contentArea = New CropRectangle(x:= 189, y:= 272, height:= 252, width:= 77)
	' Add the specific region of the image to the OCR input
	input.AddImage("D:\subtitle\image.png", contentArea)
	' Perform OCR on the specified region
	Dim result = ocr.Read(input)
	' Output the extracted text to the console
	Console.WriteLine(result.Text)
End Using
Isso resulta em um aumento de 41% na velocidade - e nos permite ser específicos. Em contentArea, especificamos o ponto de início em x e y, e depois a altura e largura da região da legenda requerida.
Salvar Legenda em um Arquivo de Texto de Legenda
Vamos salvar as legendas extraídas em um arquivo de texto.
// Initialize IronTesseract object
var ocr = new IronTesseract();
// Create an OCR Input with the specified image path
using (var input = new OcrInput(@"D:\subtitle\subtitle1.png"))
{
    // Perform OCR on the input image to extract text
    var result = ocr.Read(input);
    // Save the extracted text to a specified file path
    result.SaveAsTextFile(@"D:\subtitle\subtitlefile.txt");
}
// Initialize IronTesseract object
var ocr = new IronTesseract();
// Create an OCR Input with the specified image path
using (var input = new OcrInput(@"D:\subtitle\subtitle1.png"))
{
    // Perform OCR on the input image to extract text
    var result = ocr.Read(input);
    // Save the extracted text to a specified file path
    result.SaveAsTextFile(@"D:\subtitle\subtitlefile.txt");
}
// Initialize IronTesseract object
var ocr = new IronTesseract();
// Create an OCR Input with the specified image path
using (var input = new OcrInput(@"D:\subtitle\subtitle1.png"))
{
    // Perform OCR on the input image to extract text
    var result = ocr.Read(input);
    // Save the extracted text to a specified file path
    result.SaveAsTextFile(@"D:\subtitle\subtitlefile.txt");
}
' Initialize IronTesseract object
Dim ocr = New IronTesseract()
' Create an OCR Input with the specified image path
Using input = New OcrInput("D:\subtitle\subtitle1.png")
' Perform OCR on the input image to extract text
Dim result = ocr.Read(input)
' Save the extracted text to a specified file path
result.SaveAsTextFile("D:\subtitle\subtitlefile.txt")
End Using
' Initialize IronTesseract object
Dim ocr = New IronTesseract()
' Create an OCR Input with the specified image path
Using input = New OcrInput("D:\subtitle\subtitle1.png")
	' Perform OCR on the input image to extract text
	Dim result = ocr.Read(input)
	' Save the extracted text to a specified file path
	result.SaveAsTextFile("D:\subtitle\subtitlefile.txt")
End Using
' Initialize IronTesseract object
Dim ocr = New IronTesseract()
' Create an OCR Input with the specified image path
Using input = New OcrInput("D:\subtitle\subtitle1.png")
	' Perform OCR on the input image to extract text
	Dim result = ocr.Read(input)
	' Save the extracted text to a specified file path
	result.SaveAsTextFile("D:\subtitle\subtitlefile.txt")
End Using
result.SaveAsTextFile irá pegar o caminho de saída como argumento e salvar o arquivo no caminho fornecido.
 Um único quadro de um vídeo mais longo contendo regiões de texto para o título e as legendas do vídeo
Resumo
Neste tutorial, aprendemos a usar o IronOCR e desenvolver um programa muito simples para ler legendas da captura de tela do vídeo. Também podemos especificar a região da qual queremos extrair o texto.
IronOCR fornece as funcionalidades do OpenCV para Visão Computacional. Vimos que o IronOCR nos permite ler texto de imagens borradas ou de baixa resolução. Esta biblioteca é eficiente e fornece precisão. Suporta mais de 125 idiomas com total precisão. É gratuito para desenvolvimento e não possui restrições para produção.
Em resumo, IronOCR fornece:
- Capacidade de escanear e ler imagens e documentos escaneados
- Suporte para 150+ idiomas globais
- Saída como texto, dados estruturados ou PDFs pesquisáveis
- Suporta .NET 6, 5, Core, Standard, Framework
IronOCR faz parte da suíte de bibliotecas do Iron Software útil para ler e escrever PDFs, manipular arquivos Excel, ler texto a partir de imagens e raspar conteúdo de sites. Compre a Iron Suite completa pelo preço de duas bibliotecas individuais.