


Atualizado 4 de junho de 2026
Como criar modelos de formulário preenchíveis em C# usando IronWord
Aprenda como criar modelos de formulários preenchíveis em C# usando o IronWord.
Leia mais

Normalmente, a principal tarefa em aplicativos de processamento de documentos, extração de dados ou análise de texto é a extração de texto de arquivos de documento Word. Ao desenvolver um aplicativo C#, os desenvolvedores usam bibliotecas como o IronWord, que ajudam a trabalhar com arquivos no formato .docx e acessar o texto dentro da instância do documento. O uso dessas bibliotecas ajuda a automatizar a maneira como o conteúdo é recuperado dos documentos Word para possibilitar a geração de relatórios, mineração de dados, ou até mesmo um sistema de gerenciamento de documentos.
Usando uma biblioteca como o IronWord, é possível extrair texto de qualquer instância de documento Word; basta carregar o objeto do documento, abrir parágrafos ou seções e, em seguida, recuperar o texto desejado, mantendo ainda seu layout original. Tal funcionalidade será de utilidade excepcional nas áreas jurídica, de saúde e financeira, onde o processamento de documentos é normalmente uma parte integral dos fluxos de trabalho. O C# é, sem dúvida, utilizado para desenvolver aplicativos extremamente escaláveis e eficientes que extraem texto de arquivos Word. Os desenvolvedores podem combiná-lo com sistemas ou aplicativos mais extensos.
using IronWord; no topo do seu arquivo C# para extrair texto do Word.Paragraphs.foreach.Console.IronWord é uma ferramenta poderosa para recuperar texto, garantindo que todos os tipos de arquivos, como PDF, Word e TXT, sejam obtidos facilmente. É projetado com precisão e velocidade para extração rápida no texto necessário, estruturado ou não estruturado, enquanto mantém o formato original do restante do documento. IronWord também é utilizado para fornecer análise de documentos, extração de dados e indexação automática de conteúdo.

Esta ferramenta suporta quase todos os tipos de arquivos disponíveis para garantir integração suave com aplicações, sendo, portanto, ideal para automação empresarial e processamento de documentos em grande volume. A escalabilidade das bibliotecas projetadas dessa maneira permite fácil manipulação de grandes volumes de documentos, o que é um ativo bastante importante para empresas que trabalham com extração de dados em massa.
IronWord também é totalmente compatível com C# e outras linguagens de programação, atendendo às necessidades de desenvolvedores e organizações que buscam otimizar seus fluxos de trabalho de documentos sem problemas.
IronWord aceita arquivos em uma variedade de formatos de documento, incluindo:
O mecanismo de extração do IronWord é adequado para extrair conteúdo textual, mesmo se estiver enterrado dentro de documentos complexos com layouts de páginas sofisticados, fontes incorporadas ou uma mistura de conteúdos, como imagens e tabelas. A biblioteca preserva:
IronWord lida com dados estruturados e não estruturados. Ele pode extrair:
Foi provado ser útil em tarefas envolvendo mineração de dados, recuperação de informações e classificação devido à sua capacidade de processar uma ampla gama de conteúdos.
IronWord é construído para processar grandes volumes de documentos de forma eficiente, oferecendo grande escalabilidade para aplicações empresariais. Exemplos incluem:
IronWord integra-se perfeitamente aos ambientes de desenvolvimento, especialmente Python, por meio de APIs fáceis de usar. Isso permite que os desenvolvedores:
Essa facilidade de integração permite que os desenvolvedores se concentrem na funcionalidade, em vez de na infraestrutura.
IronWord foi otimizado para desempenho, proporcionando extração rápida de texto, mesmo de documentos grandes, o que é essencial para aplicações em tempo real que requerem execução rápida. A biblioteca oferece:
Para documentos que contêm imagens, IronWord pode ser usado junto com tecnologias de OCR para:
Além de extrair texto, IronWord preserva metadados de documentos, como:
Para iniciar o aplicativo Visual Studio, escolha Arquivo no menu Arquivo e selecione "Novo Projeto" antes de selecionar "Aplicativo de Console".

Digite o nome do projeto .NET no campo de texto após selecionar sua localização, então clique no botão Criar e selecione o .NET Framework necessário.

As estruturas de projeto do Visual Studio variam com base na aplicação selecionada. Para implementar ou executar o código da aplicação, visite o arquivo Program.cs, aplicável em console, windows ou aplicações online.

A biblioteca pode então ser testada uma vez que o código é inserido.
No menu Ferramentas do Visual Studio, escolha Gerenciador de Pacotes NuGet. Para acessar o console de gerenciamento de pacotes, navegue até a interface do Gerenciador de Pacotes.
Uma vez baixado e instalado, o pacote pode ser usado para extração de texto em um projeto em andamento.

O método Gerenciador de Pacotes oferece outra opção, permitindo instalação direta na solução via Gerenciador de Pacotes NuGet do Visual Studio. O gráfico abaixo ilustra como acessar o Gerenciador de Pacotes.

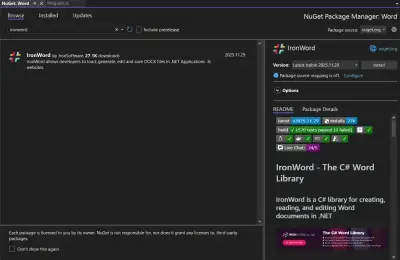
Use o campo de busca no site NuGet para localizar pacotes. Procure por "IronWord" com o gerenciador de pacotes, conforme mostrado na captura de tela abaixo.

O gráfico acompanhante exibe resultados de busca relacionados. Por favor, faça esses ajustes para instalar o software no seu computador.
Para extrair texto de um documento usando IronWord, siga estas etapas. O exemplo de código abaixo demonstra a extração de texto de um documento Word (.docx) usando a biblioteca IronWord em C#.
// Include necessary libraries
using IronWord;

// Set the license key for IronWord
IronWord.License.LicenseKey = "License key here";

// Load the Word document
var docx1 = new WordDocument("D:\\C# Projects\\ConsoleApp\\ConsoleApp\\File\\existing.docx");

// Access the collection of paragraphs in the document
var paragraphObj = docx1.Paragraphs;

// Loop through each paragraph and its text elements
for (int i = 0; i < paragraphObj.Count; i++)
{
    for (int j = 0; j < paragraphObj[i].Texts.Count; j++)
    {
        // Print each text element to the console
        Console.WriteLine(paragraphObj[i].Texts[j].Text.ToString());
    }
}

// Wait for user input before closing the console
Console.ReadKey();' Include necessary libraries
Imports IronWord
' Set the license key for IronWord
IronWord.License.LicenseKey = "License key here"
' Load the Word document
Dim docx1 = New WordDocument("D:\C# Projects\ConsoleApp\ConsoleApp\File\existing.docx")
' Access the collection of paragraphs in the document
Dim paragraphObj = docx1.Paragraphs
' Loop through each paragraph and its text elements
For i As Integer = 0 To paragraphObj.Count - 1
Dim j As Integer = 0
Do While j < paragraphObj(i).Texts.Count
' Print each text element to the console
Console.WriteLine(paragraphObj(i).Texts(j).Text.ToString())
j += 1
Loop
Next i
' Wait for user input before closing the console
Console.ReadKey()' Include necessary libraries
Imports IronWord
' Set the license key for IronWord
IronWord.License.LicenseKey = "License key here"
' Load the Word document
Dim docx1 = New WordDocument("D:\C# Projects\ConsoleApp\ConsoleApp\File\existing.docx")
' Access the collection of paragraphs in the document
Dim paragraphObj = docx1.Paragraphs
' Loop through each paragraph and its text elements
For i As Integer = 0 To paragraphObj.Count - 1
Dim j As Integer = 0
Do While j < paragraphObj(i).Texts.Count
' Print each text element to the console
Console.WriteLine(paragraphObj(i).Texts(j).Text.ToString())
j += 1
Loop
Next i
' Wait for user input before closing the console
Console.ReadKey()O código inicializa a chave de licença para IronWord e carrega um documento .docx de um caminho especificado, criando um objeto WordDocument. Após o carregamento do documento, ele acessa todos os parágrafos através da propriedade Paragraphs.

Um loop aninhado itera sobre parágrafos e seus elementos de texto. O loop externo percorre cada parágrafo, enquanto o loop interno processa os elementos de texto de cada parágrafo. Elementos de texto são impressos no console após conversão para strings.

Console.ReadKey() suspende a execução do programa, permitindo a exibição da saída até que o usuário insira um comando antes de fechar a janela da aplicação. Esta abordagem extrai e imprime conteúdos de documentos Word ordenadamente.
IronWord é uma ferramenta versátil e eficiente para extração de texto em vários formatos de documentos, particularmente adequada para documentos Word. Sua API amigável e recursos de extração de texto estruturados fazem dela uma solução confiável para desenvolvedores que buscam recuperação automatizada de conteúdo de documentos. A ferramenta mantém o formato enquanto processa documentos complexos, provando-se valiosa para gestão de conteúdo em nível jurídico, empresarial e outras aplicações. Implementar IronWord aprimora a análise de documentos, extração de dados e tarefas de processamento, aumentando a produtividade e a precisão ao lidar com grandes volumes de texto.
O preço inicial do IronWord é $599. Os usuários podem optar por uma taxa de assinatura anual única, obtendo acesso ao suporte técnico e atualizações de software. O IronWord envolve um custo que impede a distribuição gratuita. Consulte a página de licença do IronWord para detalhes específicos de preço. Veja outros produtos da Iron Software na página de produtos.

Curtis Chau é bacharel em Ciência da Computação (Universidade Carleton) e se especializa em desenvolvimento front-end, com experiência em Node.js, TypeScript, JavaScript e React. Apaixonado por criar interfaces de usuário intuitivas e esteticamente agradáveis, Curtis gosta de trabalhar com frameworks modernos e criar manuais bem estruturados e visualmente atraentes.

IronWord faz parte do IRON SUITE.
10 produtos de API .NET para seus documentos de escritório

Quando você precisa criar, editar e formatar documentos do Word rapidamente.


