C#ウェブスクレイピングライブラリ
基本的なHTML解析の枠を超えて。.NET 10向けの自動Webスクレイピングをマルチスレッド対応で提供し、大規模に構造化データを抽出してエクスポートできます。
- CSSセレクタ、XPath、JavaScriptレンダリングを使用したスクレイピング。
- マルチスレッド処理による数百の同時リクエスト
- サポート スロットリング、プロキシ、ユーザーエージェント、および robots.txt
- 無料 30日間トライアル、フル機能、クレジットカード不要
C# ウェブスクレイパー
using IronWebScraper;

public class Program
{
    private static void Main(string[] args)
    {
        var ScrapeJob = new BlogScraper();
        ScrapeJob.Start();
    }
}

public class BlogScraper : WebScraper
{
    public override void Init()
    {
        LoggingLevel = LogLevel.All;
        Request("https://www.zyte.com/blog/", Parse);
    }

    public override void Parse(Response response)
    {
        foreach (HtmlNode title_link in response.Css(".oxy-post-title"))
        {
            string strTitle = title_link.TextContentClean;
            Scrape(new ScrapedData() { { "Title", strTitle } });
        }

        if (response.CssExists("div.oxy-easy-posts-pages > a[href]"))
        {
            string next_page = response.Css("div.oxy-easy-posts-pages > a[href]")[0].Attributes["href"];
            Request(next_page, Parse);
        }
    }
}
Imports IronWebScraper
Public Class Program
Private Shared Sub Main(args As String())
Dim ScrapeJob = New BlogScraper()
ScrapeJob.Start()
End Sub
End Class
Public Class BlogScraper
Inherits WebScraper
Public Overrides Sub Init()
LoggingLevel = LogLevel.All
Request("https://www.zyte.com/blog/", AddressOf Parse)
End Sub
Public Overrides Sub Parse(response As Response)
For Each title_link As HtmlNode In response.Css(".oxy-post-title")
Dim strTitle As String = title_link.TextContentClean
Scrape(New ScrapedData() From {{"Title", strTitle}})
Next
If response.CssExists("div.oxy-easy-posts-pages > a[href]") Then
Dim next_page As String = response.Css("div.oxy-easy-posts-pages > a[href]")(0).Attributes("href")
Request(next_page, AddressOf Parse)
End If
End Sub
End Class
PM >Install-Package IronWebScraper


Works with AI Coding Agents
 Claude
 Codex
 GitHub Copilot
 Cursor
 Antigravity
 Other coding agents
Runs Inside Your Infrastructure
No MCPs or external processing. IronWebScraper runs inside your application, keeping documents in your control.
AI-ready Documentation
Clear documentation, API references, and tutorials help coding agents use IronWebScraper effectively.
Built for Enterprise Workflows
Add enterprise-grade document capabilities where accuracy, consistency, and control matters.
クロスプラットフォームのサポート
C#, F#, & VB.NET 用に設計されており、.NET 10, 9, 8, 7, 6, 5, Core, Standard, または Framework 上で動作します


なぜIronWebScraperか
単一のC#クラスから数千のページをスクレイピングします。CSSセレクタ、XPath、JavaScriptレンダリング、仮想ID、好意的制御を1つのライブラリで実行。

 幅広いスクレイピング機能
- CSSセレクタまたはXPath式で解析します; jQueryスタイルの構文。
- JavaScriptページをレンダリングし、静的HTMLだけでなく。
- C#クラスインスタンス、JSON、もしくはダウンロードファイルとして出力可能。
 5分で導入
- → 5分のクイックスタート。
- シンプルなAPI:
Request(url, Parse),response.Css(".selector"),Scrape(data). - スマートなデフォルト: マルチスレッド、好意的制御、およびキャッシュをフレームワークが処理。
 Enterprise業績
- .NET 10、Core、Standard、またはFramework
- C#、VB.NET、F#対応。DigiCert署名済みバイナリ。
- どこでもデプロイ可能: Windows、Linux、macOS、Docker、Azure、AWS。

 好意的で、耐障害性があり、監査フレンドリー
- スロットリング、プロキシサポート、ユーザーエージェント、robots.txtの準拠を内蔵。
- 仮想ユーザーID: リクエストごとのユーザーエージェント、クッキー、ログイン、IP。
- 例外、クラッシュ、または停電後に自動保存されたジョブが再開。
 開発者優先のサポートとライセンス
- 永続的ライセンス:一度購入して永遠に使用可能。オプションの更新と更新。
- 24時間365日エンジニアサポート(24/7 Premium対応)。リアルな人間、中央値チャット応答時間<1分。
- 30日間の返金保証適していませんか?全額返金、質問なし。
 ビルダー向け
- 本当に使う機能:
- CSSセレクタとXPath
- multithreaded crawling
- プロキシとユーザーエージェントのローテーション
- 仮想ユーザーID
- auto-resume on crash
- JavaScriptレンダリング
- スロットリングと好意的制御
- robots.txt の準拠
- アクションリプレイ(オフライン)
- JSONまたはクラス出力
- どこでも動作: Windows, Linux, macOS, Docker, Azure, AWS。
 購入者向け
- Iron Suiteのエンジニア数百万人に信頼されています。
- 実際のワークロードのために構築: システムの移行、競合分析、検索インデックス作成、データマイニング。
- 調達にやさしい: 永続ライセンス、オプションの更新、請求書の提供、複数の支払いオプション(ローカルとしては、Amazon Pay、Alipay、Apple Pay、IDEAL、SEPA、ACHを含む)。
- 30日間の返金保証。
世界中の数百万人のエンジニアに信頼されています。


始めましょう: C# コード例
 C# ウェブスクレイパー
using IronWebScraper;

public class Program
{
    private static void Main(string[] args)
    {
        var ScrapeJob = new BlogScraper();
        ScrapeJob.Start();
    }
}

public class BlogScraper : WebScraper
{
    public override void Init()
    {
        LoggingLevel = LogLevel.All;
        Request("https://www.zyte.com/blog/", Parse);
    }

    public override void Parse(Response response)
    {
        foreach (HtmlNode title_link in response.Css(".oxy-post-title"))
        {
            string strTitle = title_link.TextContentClean;
            Scrape(new ScrapedData() { { "Title", strTitle } });
        }

        if (response.CssExists("div.oxy-easy-posts-pages > a[href]"))
        {
            string next_page = response.Css("div.oxy-easy-posts-pages > a[href]")[0].Attributes["href"];
            Request(next_page, Parse);
        }
    }
}
Imports IronWebScraper

Public Class Program
    Private Shared Sub Main(args As String())
        Dim ScrapeJob = New BlogScraper()
        ScrapeJob.Start()
    End Sub
End Class

Public Class BlogScraper
    Inherits WebScraper

    Public Overrides Sub Init()
        LoggingLevel = LogLevel.All
        Request("https://www.zyte.com/blog/", AddressOf Parse)
    End Sub

    Public Overrides Sub Parse(response As Response)
        For Each title_link As HtmlNode In response.Css(".oxy-post-title")
            Dim strTitle As String = title_link.TextContentClean
            Scrape(New ScrapedData() From {{"Title", strTitle}})
        Next

        If response.CssExists("div.oxy-easy-posts-pages > a[href]") Then
            Dim next_page As String = response.Css("div.oxy-easy-posts-pages > a[href]")(0).Attributes("href")
            Request(next_page, AddressOf Parse)
        End If
    End Sub
End Class
PM > Install-Package IronWebScraper
当社の開発チームからの直接的な人間サポート
製品、統合、またはライセンスの問い合わせであろうと、Ironの製品開発チームはすべての質問に対応します。Ironと対話を始め、このライブラリをプロジェクトで最大限に活用してください。
強力なスクレイピングエンジンを自分の手で制御
数千、いや数百万のウェブページをC#クラスインスタンス、JSON、またはダウンロードファイルにスクレイプするために、単一のC#ウェブスクレイパークラスを書くことだけです。IronWebScraperを利用すると、人間のブラウジング行動をシミュレートする簡潔かつ直線的なワークフローをコーディングすることができます。IronWebScraperは、仮想ウェブブラウザの群れとしてコードを実行し、非常に並行的でありながら丁寧で故障耐性があります。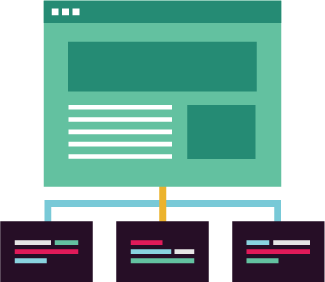
シンプルで柔軟なロジック
IronWebScraperは、出会う各「タイプ」のページをどのように扱うかを知るためにプログラムされる必要があります。これは、CSSセレクタやXPath式を使用して非常に簡潔に実現され、C#で完全にカスタマイズできます。この自由により、ウェブサイト内でスクレイプするページを決定し、抽出したデータをどのように扱うかを決定できます。各メソッドはVisual Studioで整理されてデバッグおよび監視されることができます。
高速で丁寧な動作
IronWebScraperは、マルチスレッドとウェブリクエストを扱い、開発者が管理することなく数百の同時スレッドを可能にします。丁寧さはリクエストのスロットリングに設定でき、ターゲットウェブサーバーへの過剰な負荷のリスクを減らします。
仮想ユーザーアイデンティティを作成
IronWebScraperは、一つ以上の「アイデンティティ」– 実世界の人間のリクエストをシミュレートするセッションを使用できます。各リクエストはプログラム的またはランダムに独自のアイデンティティ、ユーザーエージェント、クッキー、ログインさらにはIPアドレスを割り当てることができます。リクエストはURL、解析メソッド、およびポスト変数の組み合わせで自動ユニークに設定されます。
アクションリプレイ
IronWebScraperは、高度なキャッシュを使用して、開発者がインターネットと接触することなく「フライ」でコードを変更し、すべての以前のリクエストを再生可能にします。すべてのスクレイプジョブは自動保存され、例外や電源障害が発生した場合も再開できます。
Microsoft Visual Studioでの迅速なインストール
IronWebScraperは、Visual Studioインストーラを使用して迅速にウェブスクレイピングツールを利用できます。Visual Studio内で直接NuGetからインストールするかDllをダウンロードするかにかかわらずすぐに設定が可能です。たった1つのDLLで依存関係はありません。サポート:
.NET ウェブスクレイピングコミュニティチュートリアル
VBC#ASP.NET
C#およびVB.NETプロジェクトにおけるウェブスクレイピング
AhmedがどのようにIronWebScraperを使用して、コンテンツを一つのサイトから別のサイトに移行するかをご覧ください。サンプルプロジェクトとコードが提供されており、eコマースやブログウェブサイトのスクレイピングに役立ちます
当社の顧客はIronWebScraperを使用して...
会計および財務のシステム
- # 領収書
- # 報告
- # 請求書印刷

ビジネスのデジタル化
- # ドキュメント
- # 注文&ラベリング
- # 用紙の置き換え
エンタープライズコンテンツ管理
- # コンテンツ制作
- # ドキュメント管理
- # コンテンツ配布
データと報告アプリケーション
- # パフォーマンストラッキング
- # トレンドマッピング
- # レポート


何千もの企業、政府、小規模企業、開発者がIronソフトウェア製品を信頼しています。
Ironのチームは、.NETソフトウェアコンポーネント市場で10年以上の経験があります。



準備はできましたか?
Nuget Downloads 145,856|バージョン:2026.9リリースされたばかり

IronWebScraper はIRONSUITEの一部です
オフィス文書向けの.NET API製品10個


クリーンで構造化されたデータをスクレイピングし出力するために必要なパワー。